OmniHuman 2.0 トーキングアバター
人物画像1枚と4〜300秒のMP3またはWAV音声をアップ。音声と同じ長さの720p動画になります。OmniHuman 2.0では300文字以内のプロンプトでジェスチャーとカメラも指示できます。
ワークスペースを開くOmniHuman 2.0は、1枚の画像と1つの音声からリアルなトーキングアバター動画を作る音声駆動型のAI動画モデルです。自然なリップシンク、豊かな表情と身ぶりで、最長5分の動画を生成します。
画像+音声から動画 · 720p · 4〜300秒 · プロンプト任意
ワークフローは1つ。人物画像をアップし、話し声か歌を加え、必要なら演技を指示します。
人物画像1枚と4〜300秒のMP3またはWAV音声をアップ。音声と同じ長さの720p動画になります。OmniHuman 2.0では300文字以内のプロンプトでジェスチャーとカメラも指示できます。
ワークスペースを開くOmniHuman 2.0は、1枚の画像と音声から自然なリップシンク、表情、身ぶりのあるトーキング動画を作ります。
OmniHuman 2.0なら、1枚の画像と1つの音声ファイルからリアルなトーキングアバター動画を作れます。話し方、表情、体の動きまで音声に合わせて自然に動き、キャラクターに命が宿ります。撮影なしでAIプレゼンターやバーチャルキャラクター、デジタルアバターを作成できます。写真でもイラストでもデフォルメキャラでも、OmniHuman 2.0は元画像の顔、服装、画風をそのまま保ちます。
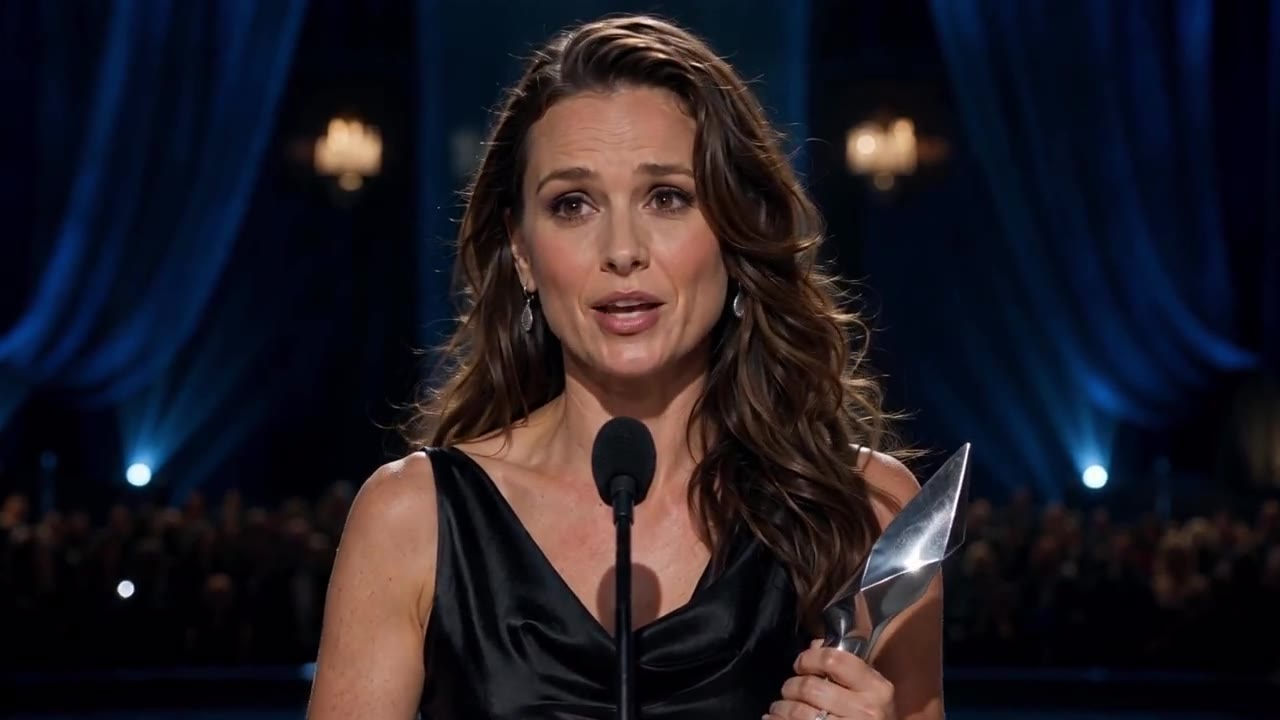
OmniHuman 2.0は、話し言葉にも歌にもぴったり合う口の動きでトーキング動画を作ります。口元は音声と同期し、顔のほかの部分も自然に動き続けます。バーチャルプレゼンター、歌うアバター、音声で動くキャラクターアニメーションに最適です。アップでも速い歌詞でもOmniHuman 2.0の口の動きはずれにくく、トーク動画も音楽パフォーマンスもどの画面で見ても自然です。
OmniHuman 2.0は基本的なリップシンクにとどまりません。音声のリズムと感情に合わせて、表情、首の動き、手振り、体の動きまで生成します。ストーリー、エンタメ、SNS向けにアバターの個性をもっと引き出せます。OmniHuman 2.0では、落ち着いた語りなら動きも穏やかに、興奮した声なら身ぶりも表情も大きくなります。
OmniHuman 2.0は最長300秒のトーキング動画に対応。動画の長さは音声に合わせて4秒から5分まで決まります。スピーチ、プレゼン、チュートリアル、歌を短いクリップをつなぐことなく1本で作れます。OmniHuman 2.0の1テイクなら、最初の一言から最後まで顔も光も構図も変わりません。
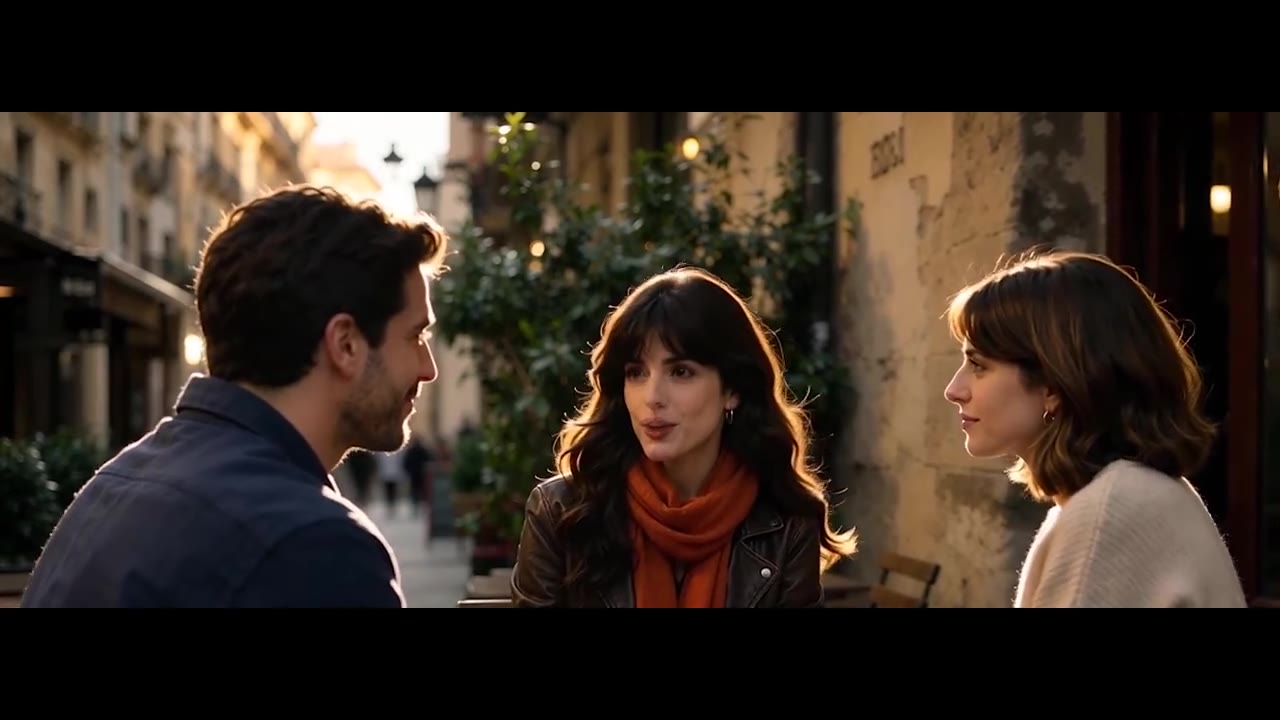
OmniHuman 2.0は1つのシーンで複数のキャラクターを動かせます。音声に合わせた表情と自然な体の動きで、会話、インタビュー、グループパフォーマンスを作成。ポッドキャストや対話の音声を魅力的な動画にできます。OmniHuman 2.0には集合写真や複数人のシーンを使い、話す人それぞれが画面にはっきり映るようにすると最もきれいに仕上がります。
OmniHuman 2.0では、画像と音声に任意のテキストプロンプトを追加できます。動き、ジェスチャー、シーンの様子、カメラワークを書いて結果を方向づけましょう。音声駆動のアニメーションとプロンプトを組み合わせて、より狙いどおりの動画に。たとえばOmniHuman 2.0に「カメラに向かって笑顔で手を振る、ゆっくりズームイン」と書けば、商品動画を親しみやすいあいさつで始められます。
OmniHuman 2.0なら3ステップでリアルなトーキング動画が完成:
ログインしてOmniHuman 2.0のワークスペースを開きます。30MB以下、各辺300〜6,000px、アスペクト比0.4〜2.5の鮮明なJPG・PNG・WEBP画像を1枚アップロード。写真、イラスト、デフォルメキャラも使えます。
MP3またはWAVの話し声や歌をアップロード(15MB以下、4〜300秒)。動画の長さは音声で決まります。必要なら300文字以内でジェスチャー、シーン、カメラの動きを指示しましょう。
クレジット見積もりを確認して生成。OmniHuman 2.0の動画は会話と「マイ作品」に表示され、すぐにプレビューやダウンロードができます。
OmniHuman 2.0は音声駆動アバターを最長5分の動画まで広げ、プレゼン、歌、デジタルヒューマンに最適です。OmniHuman 1.5は最大1080pの短いクリップ向け。どちらもリップシンク、豊かなジェスチャー、プロンプトによるアニメーションに対応します。
| 機能 | OmniHuman 2.0最長5分 | OmniHuman 1.5 |
|---|---|---|
| 位置づけ | 長尺のトーキングアバター | 短い高解像度クリップ |
| 入力 | 画像+音声+任意のプロンプト | 画像+音声+任意のプロンプト |
| 音声駆動アニメーション | 対応 | 対応 |
| リップシンク | 対応 | 対応 |
| 表情 | 対応 | 対応 |
| ボディジェスチャー | 対応 | 対応 |
| 複数人アニメーション | 対応 | 対応 |
| プロンプト制御 | 対応 | 対応 |
| 最大動画長 | 最長300秒 | 60秒未満 |
| 動画の長さ | 音声に合わせて4〜300秒 | 音声に合わせる |
| 出力解像度 | 720p | 720p / 1080p |
| おすすめ用途 | 講演、講座、歌、ポッドキャスト | 短い高解像度アバタークリップ |
OmniHuman 2.0はByteDanceの音声駆動型AI動画モデルです。キャラクター画像と音声ファイルから、口の動き、表情、身ぶりが同期したトーキングアバター動画を作ります。OmniHuman 2.0は実写、イラスト、デフォルメキャラに対応し、最長5分の720p動画を作れます。
OmniHuman 2.0は音声の話し方、リズム、感情を解析し、それに合った口の動き、表情、身ぶりで画像を動かします。任意のプロンプトで動きやカメラも指示できます。OmniHuman 2.0では、雑音の少ないクリアな声ほどリップシンクが正確になります。
画像はJPG・PNG・WEBPを1枚(30MB以下、各辺300〜6,000px、アスペクト比0.4〜2.5)。音声はMP3またはWAV(15MB以下、4〜300秒)です。条件に合わないファイルは、アップロード欄が具体的な理由を表示します。
OmniHuman 2.0は4〜300秒(5分)の動画を作れます。動画の長さは常に音声と同じで、720pで出力されます。
OmniHuman 2.0は音声1秒あたり28クレジット。10秒の動画は280、1分は1,680、5分は8,400クレジットです。音声を追加するとワークスペースに正確な見積もりが表示されます。OmniHuman 2.0はVIP限定です。
はい。OmniHuman 2.0は1つのシーンで複数人を動かせるので、インタビュー、ポッドキャスト、グループパフォーマンスに向いています。仕上がりは画像、音声、シーンの複雑さによって変わります。OmniHuman 2.0で最もきれいに仕上げるには、全員の顔がはっきり見えて明るく写った画像を使いましょう。
OmniHuman 2.0は最長300秒の720p動画を作れ、講演、レッスン、歌に最適です。OmniHuman 1.5は最大1080pの60秒未満のクリップ向けです。どちらも音声駆動のリップシンク、表情、ジェスチャーに対応します。
はい。300文字以内の任意のプロンプトで、動き、ジェスチャー、シーン、カメラを指示できます。中国語、英語、日本語、韓国語、スペイン語、インドネシア語に対応。最終的な動きは音声にも合わせて決まります。
はい。MP3またはWAVの曲をアップすると、OmniHuman 2.0が口、呼吸、体のリズムを音楽に合わせます。バーチャルシンガー、デジタルアイドル、最長5分のMVに最適です。
OmniHuman 2.0は、AIプレゼンター、UGC風の商品広告、講座・研修動画、ビジュアルポッドキャスト、バーチャルシンガー、イラストのアニメ化に使えます。人物画像と音声があれば、撮影なしでトーキング動画になります。
ログインしてVIPを有効にし、このページからOmniHuman 2.0のワークスペースを開きます。人物画像と音声をアップし、必要ならプロンプトを加えて生成。コードもソフトのインストールも不要です。最初のトーキング動画は数分で完成します。