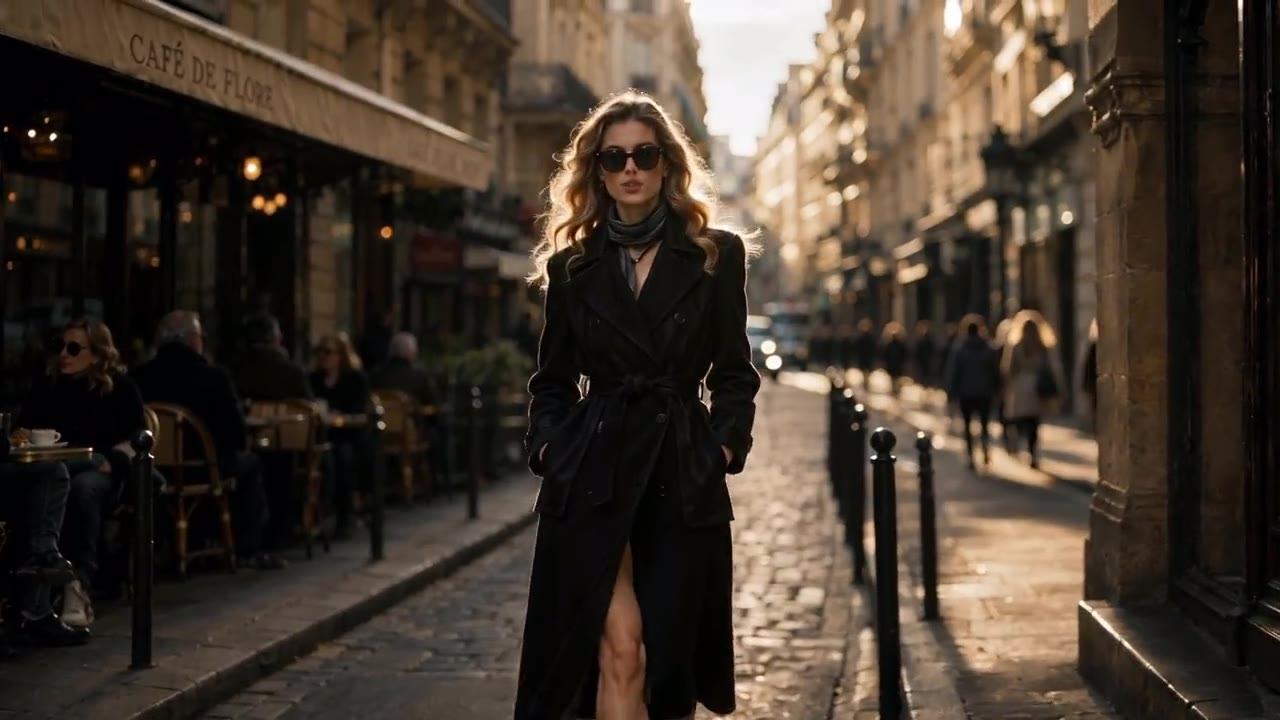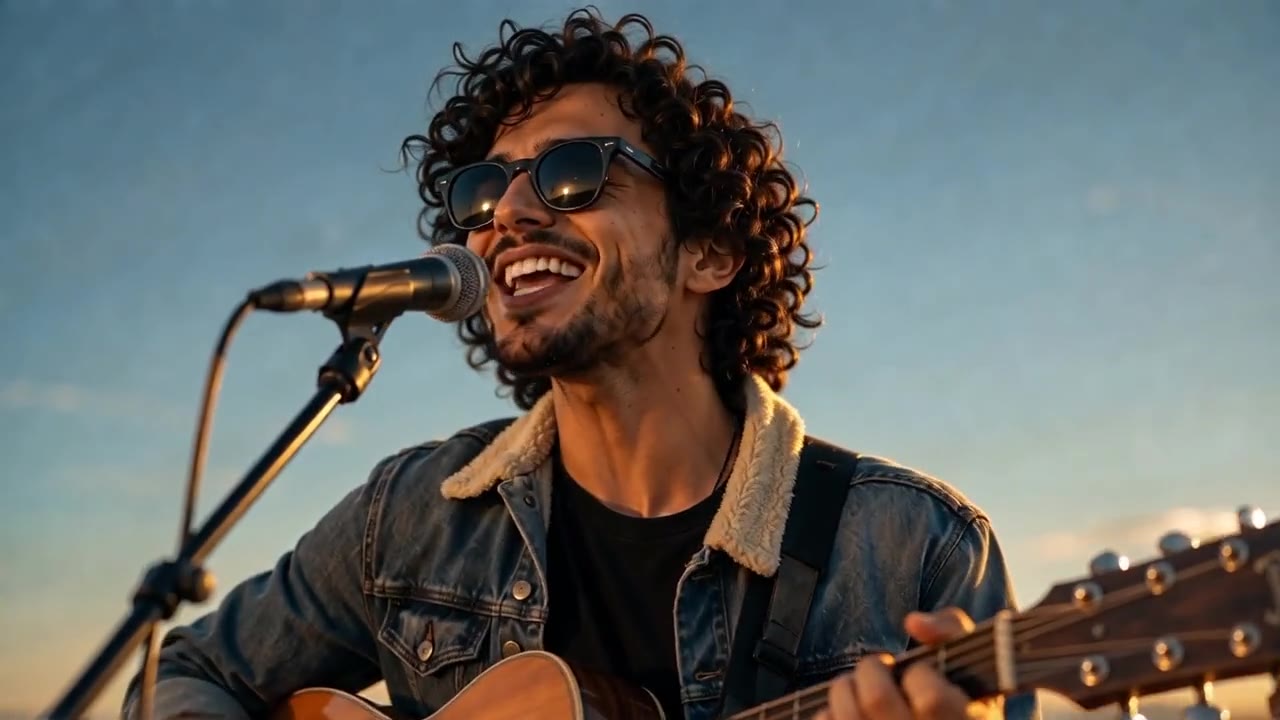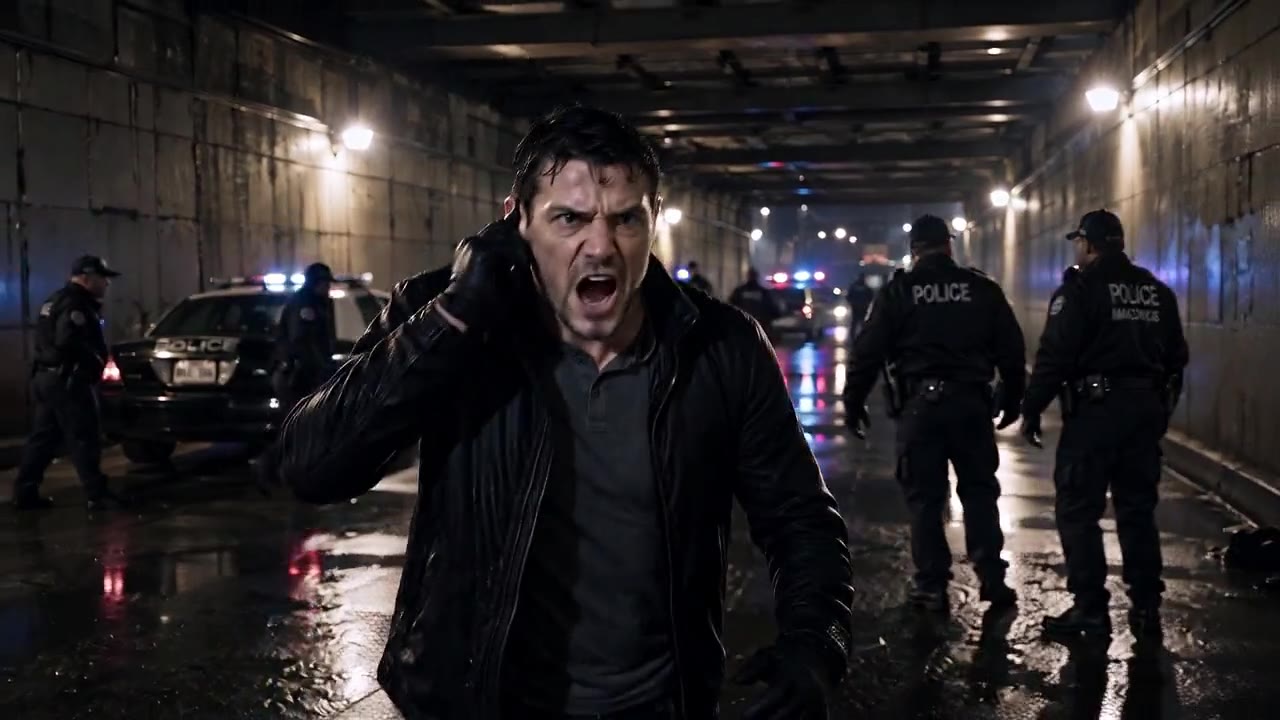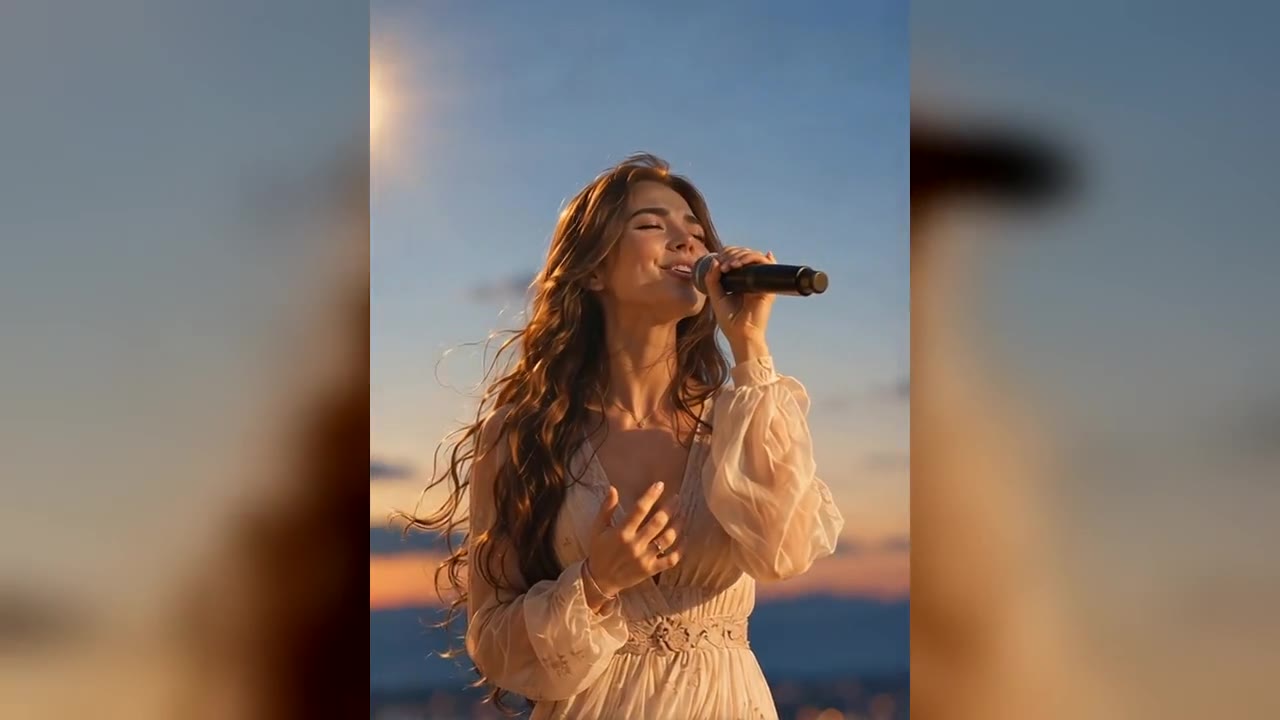
Avatar parlant OmniHuman 2.0
Importez un portrait et 4 à 300 secondes d’audio MP3 ou WAV. La vidéo 720p suit la durée de l’audio. Ajoutez un prompt facultatif de 300 caractères pour guider gestes et caméra.
Ouvrir l’espace de travailOmniHuman 2.0 est un modèle vidéo IA guidé par l’audio qui transforme une image et un audio en vidéo réaliste d’avatar parlant, avec synchronisation labiale naturelle, visages expressifs, gestes et jusqu’à 5 minutes de durée.
Image + audio en vidéo · 720p · 4–300 secondes · prompt facultatif
Un seul flux : importez un portrait, ajoutez voix ou chant et décrivez la performance si vous le souhaitez.
Importez un portrait et 4 à 300 secondes d’audio MP3 ou WAV. La vidéo 720p suit la durée de l’audio. Ajoutez un prompt facultatif de 300 caractères pour guider gestes et caméra.
Ouvrir l’espace de travailOmniHuman 2.0 transforme une image et votre audio en vidéo parlante, avec synchronisation labiale naturelle, expressions et gestes.
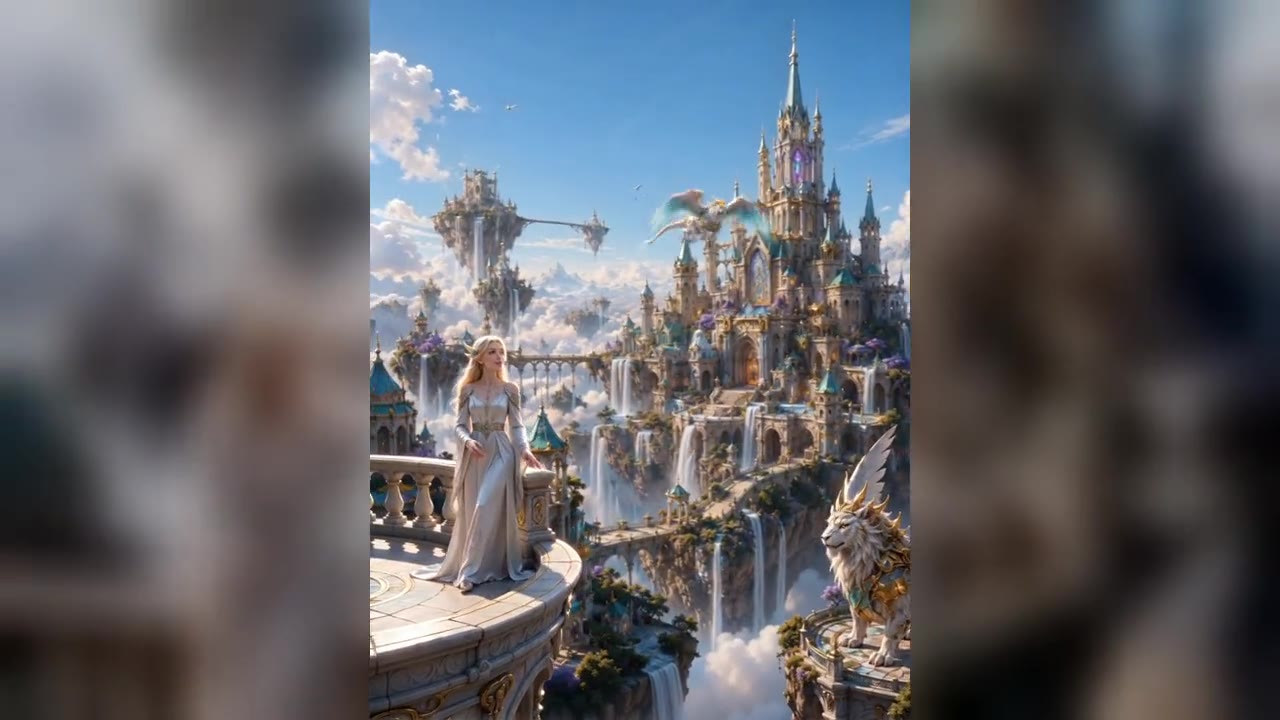
Avec OmniHuman 2.0, une seule image et un fichier audio deviennent une vidéo réaliste d’avatar qui parle. Le modèle donne vie aux personnages avec une parole, des expressions et des mouvements naturels, tous guidés par l’audio. Créez des présentateurs IA, des personnages virtuels et des avatars numériques sans tournage. Importez une photo, une illustration ou un personnage stylisé : le visage, la tenue et le style restent fidèles à votre image.
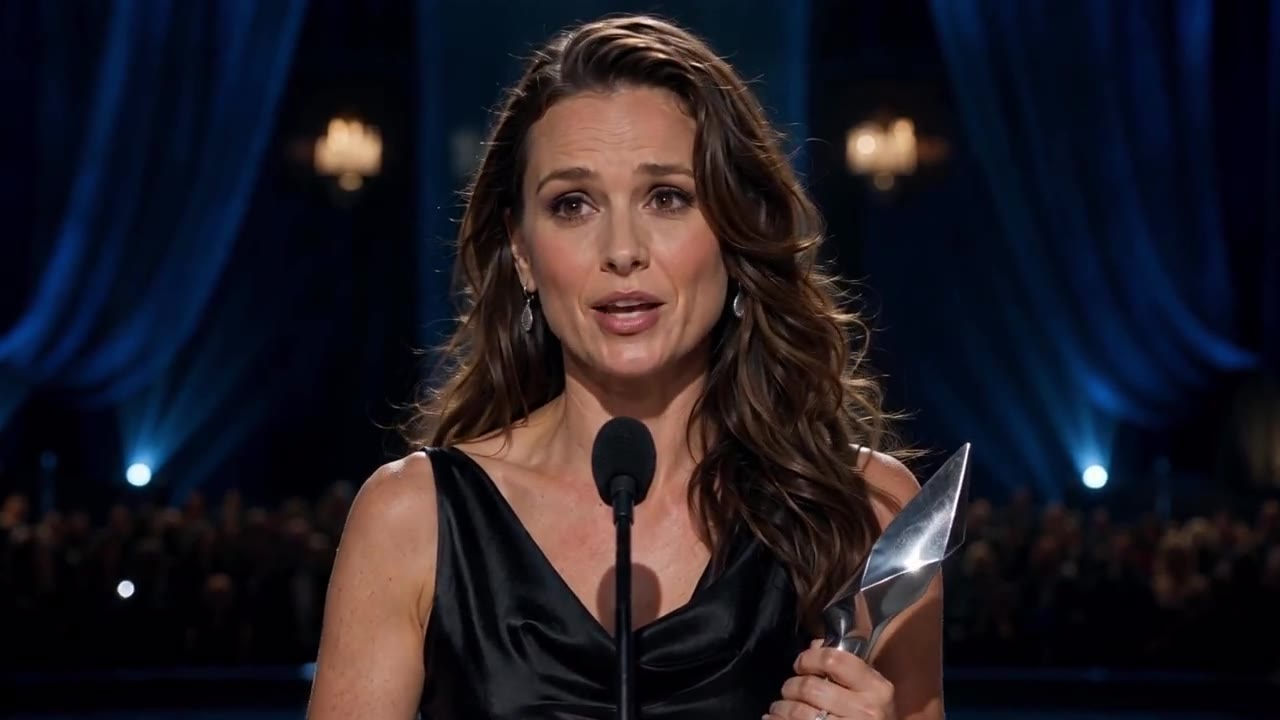
OmniHuman 2.0 crée des vidéos où les lèvres suivent de près les mots prononcés et le chant. La bouche reste synchronisée avec l’audio tandis que le reste du visage bouge naturellement. Idéal pour les présentateurs virtuels, les avatars qui chantent et l’animation de personnages par la voix. La synchronisation d’OmniHuman 2.0 tient en gros plan comme sur des paroles rapides : vidéos face caméra et performances musicales convainquent sur tous les écrans.
OmniHuman 2.0 va au-delà de la simple synchronisation labiale. Il génère des expressions, des mouvements de tête, des gestes des mains et du corps qui répondent au rythme et à l’émotion de l’audio. Donnez plus de personnalité à vos avatars pour le storytelling, le divertissement et les réseaux sociaux. Une narration calme reste douce, tandis qu’une voix enthousiaste apporte des gestes plus amples et des expressions plus vives.
OmniHuman 2.0 prend en charge des vidéos parlantes jusqu’à 300 secondes. La durée suit votre audio, de 4 secondes à 5 minutes. Produisez discours, présentations, tutoriels et chansons complets d’un seul coup, sans assembler de courts clips. Une seule prise continue d’OmniHuman 2.0 garde le même visage, la même lumière et le même cadre du premier au dernier mot.
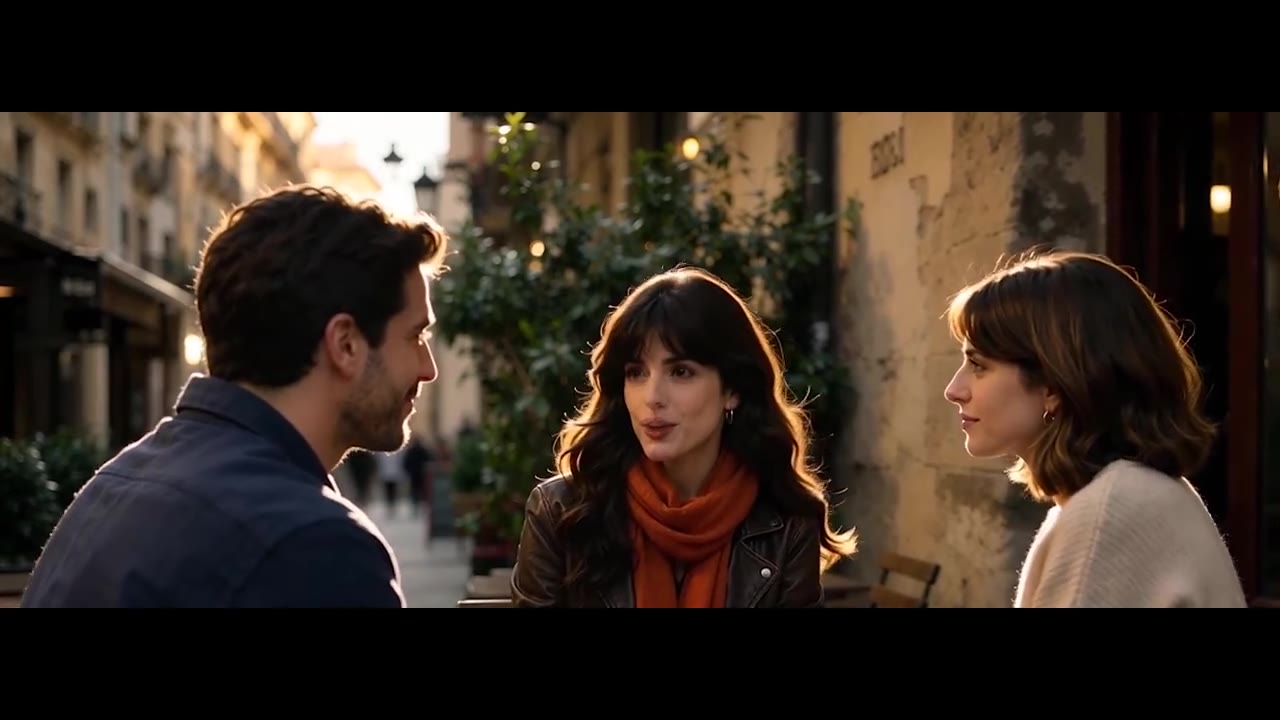
OmniHuman 2.0 peut animer plusieurs personnages dans une même scène. Créez conversations, interviews et performances de groupe avec des expressions guidées par l’audio et des mouvements naturels. Transformez podcasts et dialogues en vidéos captivantes. Utilisez une photo de groupe ou une scène à plusieurs et laissez de la place à chaque personne qui parle pour un rendu plus net.
Dans OmniHuman 2.0, ajoutez un prompt facultatif à votre image et à votre audio. Décrivez actions, gestes, comportement de la scène et mouvements de caméra pour façonner le résultat. Associez l’animation guidée par l’audio au prompt pour des vidéos mieux maîtrisées. Par exemple, écrivez « sourit et salue la caméra, travelling avant lent » pour ouvrir une vidéo produit par un accueil chaleureux.
Créez une vidéo parlante réaliste dans OmniHuman 2.0 en trois étapes :
Connectez-vous et ouvrez l’espace OmniHuman 2.0. Importez une image JPG, PNG ou WEBP nette de 30 Mo maximum, 300 à 6 000 px par côté, avec un ratio entre 0,4 et 2,5. Photos, illustrations et personnages stylisés conviennent.
Importez une voix ou un chant en MP3 ou WAV, jusqu’à 15 Mo et de 4 à 300 secondes. L’audio fixe la durée de la vidéo. Si vous voulez, décrivez gestes, scène ou caméra en 300 caractères maximum.
Vérifiez le devis en crédits et lancez la génération. Votre vidéo OmniHuman 2.0 apparaît dans la conversation et dans Mes créations, prête à être visionnée et téléchargée.
OmniHuman 2.0 étend les avatars guidés par l’audio à des vidéos de 5 minutes, idéales pour les présentations, le chant et les humains numériques. OmniHuman 1.5 produit des clips plus courts jusqu’en 1080p. Les deux gèrent la synchronisation labiale, les gestes expressifs et l’animation guidée par prompt.
| Fonctionnalité | OmniHuman 2.0Jusqu’à 5 min | OmniHuman 1.5 |
|---|---|---|
| Positionnement | Avatars parlants longs | Clips courts haute résolution |
| Entrée | Image + audio + prompt facultatif | Image + audio + prompt facultatif |
| Animation guidée par l’audio | Oui | Oui |
| Synchronisation labiale | Oui | Oui |
| Expressions du visage | Oui | Oui |
| Gestes du corps | Oui | Oui |
| Animation multi-personnes | Oui | Oui |
| Contrôle par prompt | Oui | Oui |
| Durée maximale | Jusqu’à 300 secondes | Moins de 60 secondes |
| Durée | Suit l’audio, 4–300 s | Suit l’audio |
| Résolution de sortie | 720p | 720p / 1080p |
| Idéal pour | Conférences, cours, chansons et podcasts | Courts clips d’avatar haute résolution |
OmniHuman 2.0 est le modèle vidéo IA de ByteDance guidé par l’audio. Il transforme l’image d’un personnage et un fichier audio en vidéo d’avatar parlant, avec lèvres, expressions et gestes synchronisés. OmniHuman 2.0 fonctionne avec des photos, des illustrations et des personnages stylisés, et crée des vidéos jusqu’à 5 minutes en 720p.
OmniHuman 2.0 analyse la voix, le rythme et l’émotion de votre audio, puis anime votre image avec des lèvres, expressions et gestes assortis. Un prompt facultatif guide les actions et la caméra. Une voix claire avec peu de bruit de fond donne la synchronisation labiale la plus précise.
Importez une image JPG, PNG ou WEBP de 30 Mo maximum, 300 à 6 000 px par côté, avec un ratio de 0,4 à 2,5. L’audio doit être en MP3 ou WAV, jusqu’à 15 Mo et de 4 à 300 secondes. Si un fichier ne convient pas, la zone d’import indique la raison exacte.
OmniHuman 2.0 produit des vidéos de 4 à 300 secondes (5 minutes). La vidéo a toujours la durée de votre audio et sort en 720p.
OmniHuman 2.0 utilise 28 crédits par seconde d’audio. Une vidéo de 10 secondes coûte 280 crédits, 1 minute 1 680 et 5 minutes 8 400. L’espace de travail affiche le devis exact dès l’ajout de l’audio. OmniHuman 2.0 nécessite le VIP.
Oui. OmniHuman 2.0 peut animer plusieurs personnes dans une scène, idéal pour les interviews, podcasts et performances de groupe. Le résultat dépend de l’image, de l’audio et de la complexité de la scène. Pour un résultat net, utilisez une image où chaque visage est visible et bien éclairé.
OmniHuman 2.0 crée des vidéos plus longues, jusqu’à 300 secondes en 720p, idéales pour conférences, cours et chansons. OmniHuman 1.5 vise des clips de moins de 60 secondes jusqu’en 1080p. Les deux offrent synchronisation labiale, expressions et gestes guidés par l’audio.
Oui. Ajoutez un prompt facultatif de 300 caractères maximum pour décrire actions, gestes, scène ou caméra. Les prompts fonctionnent en chinois, anglais, japonais, coréen, espagnol et indonésien. Le mouvement final suit aussi l’audio.
Oui. Importez une chanson en MP3 ou WAV et OmniHuman 2.0 cale lèvres, respiration et rythme du corps sur la musique. Idéal pour chanteurs virtuels, idoles numériques et clips jusqu’à 5 minutes.
Utilisez OmniHuman 2.0 pour des présentateurs IA, des pubs produit façon UGC, des vidéos de cours et de formation, des podcasts vidéo, des chanteurs virtuels et des illustrations animées. Tout portrait et tout enregistrement vocal devient une vidéo parlante, sans tournage.
Connectez-vous, activez le VIP et ouvrez l’espace OmniHuman 2.0 depuis cette page. Importez un portrait et votre audio, ajoutez un prompt si besoin et lancez. Ni code ni logiciel à installer. Votre première vidéo parlante peut être prête en quelques minutes.