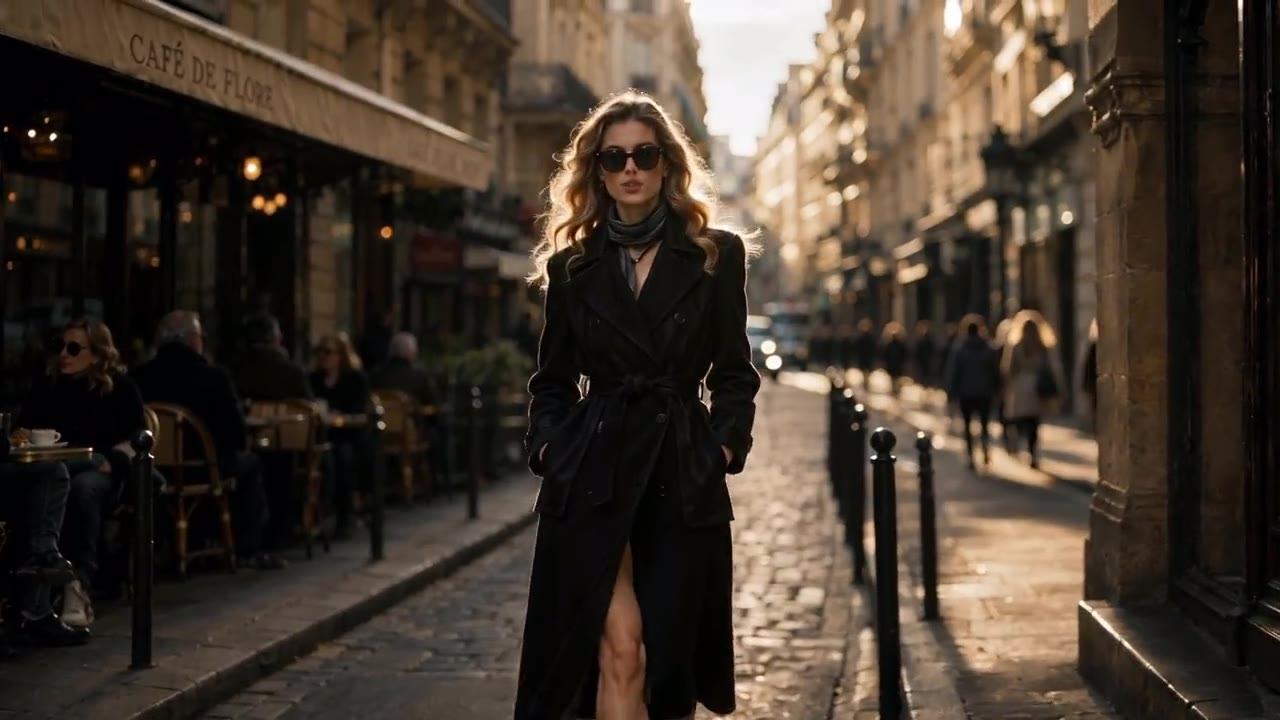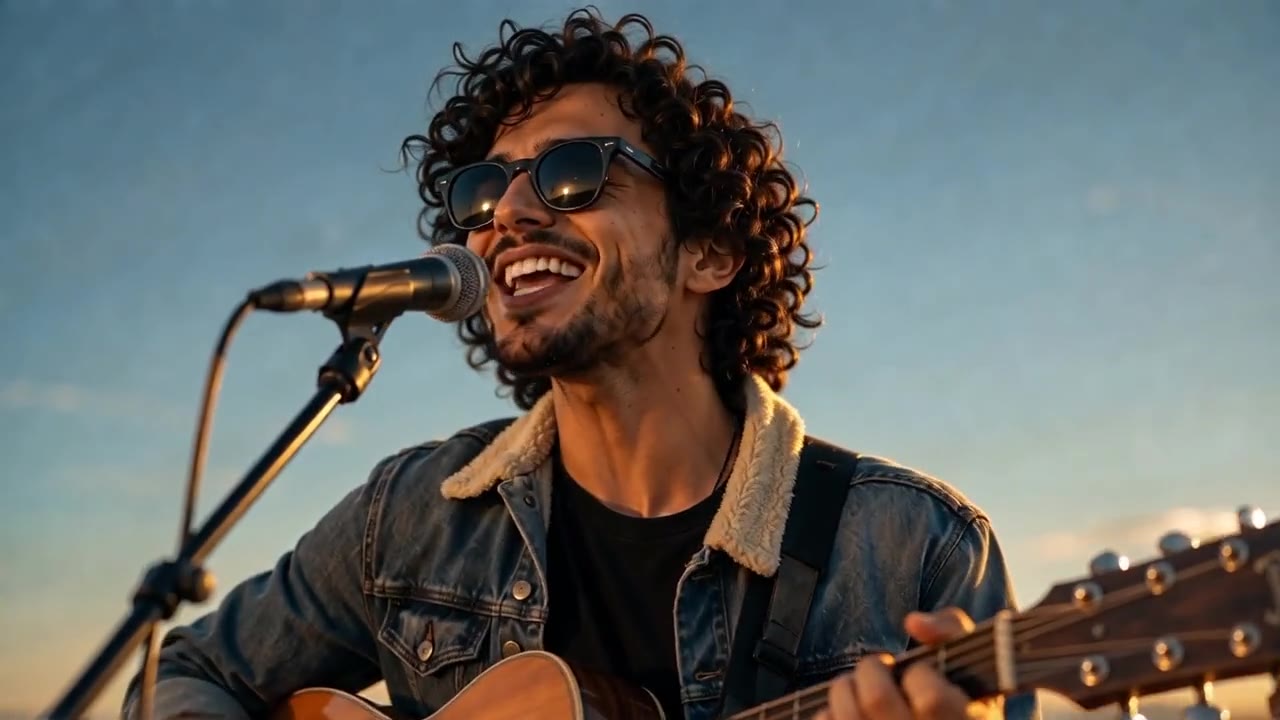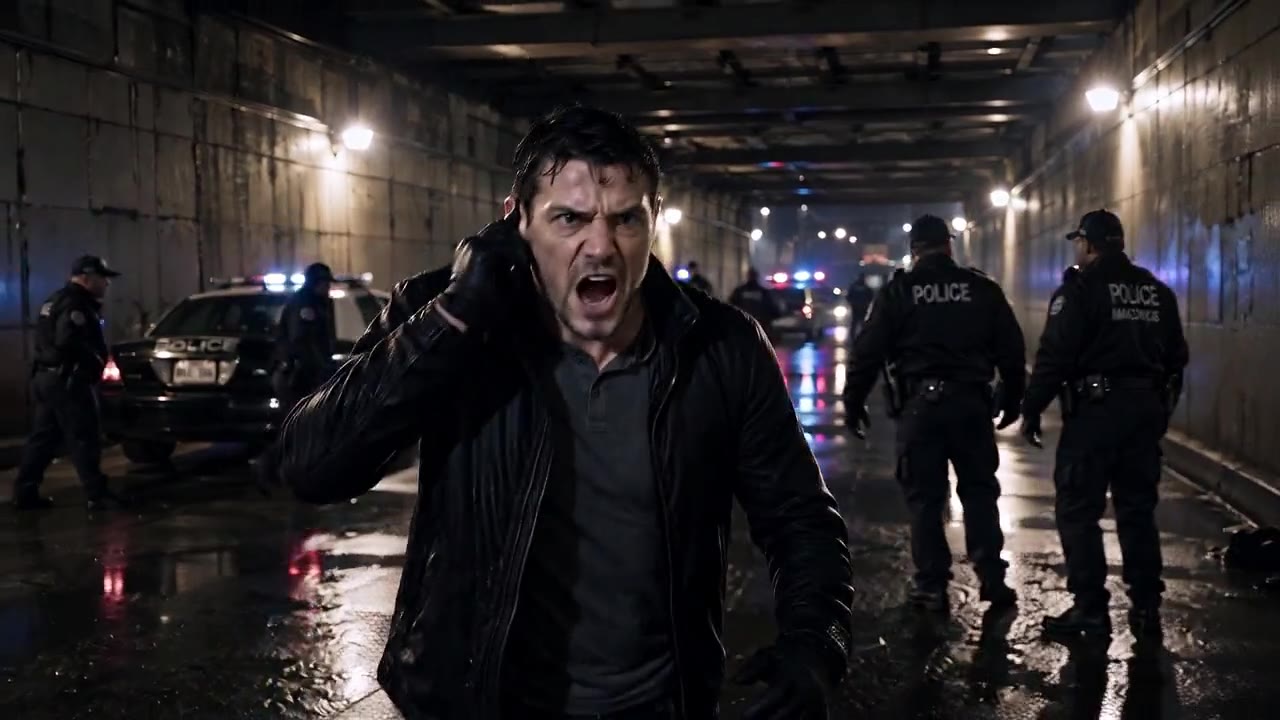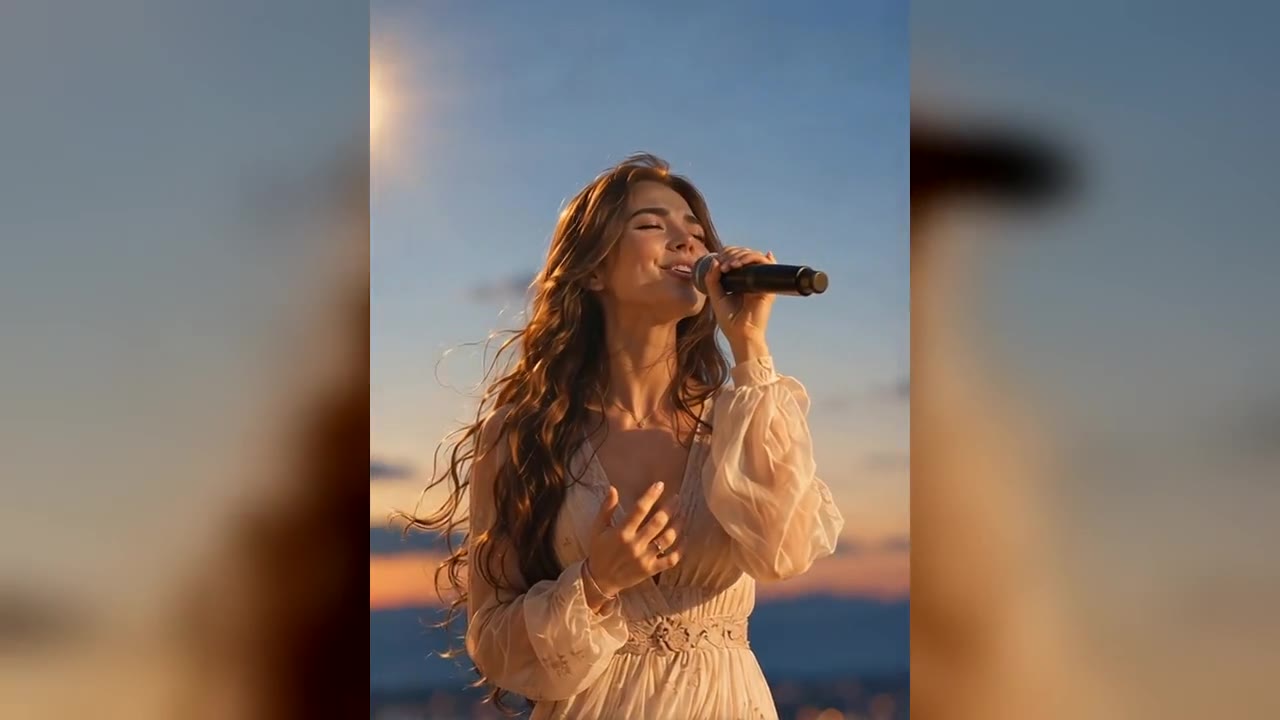
OmniHuman 2.0 sprechender Avatar
Lade ein Porträt und 4–300 Sekunden MP3- oder WAV-Audio hoch. Das 720p-Video folgt der Audiolänge. Ein optionaler Prompt bis 300 Zeichen lenkt Gesten und Kamera.
Arbeitsbereich öffnenOmniHuman 2.0 ist ein audiogesteuertes KI-Videomodell, das aus einem Bild und einer Audiodatei ein lebensechtes Video mit sprechendem Avatar macht – mit natürlicher Lippensynchronität, ausdrucksstarker Mimik, Körpergesten und bis zu 5 Minuten Länge.
Bild + Audio zu Video · 720p · 4–300 Sekunden · optionaler Prompt
Ein Workflow: Porträt hochladen, Sprache oder Gesang hinzufügen und optional die Performance beschreiben.
Lade ein Porträt und 4–300 Sekunden MP3- oder WAV-Audio hoch. Das 720p-Video folgt der Audiolänge. Ein optionaler Prompt bis 300 Zeichen lenkt Gesten und Kamera.
Arbeitsbereich öffnenOmniHuman 2.0 macht aus einem Bild und deinem Audio ein sprechendes Video mit natürlicher Lippensynchronität, Mimik und Gesten.
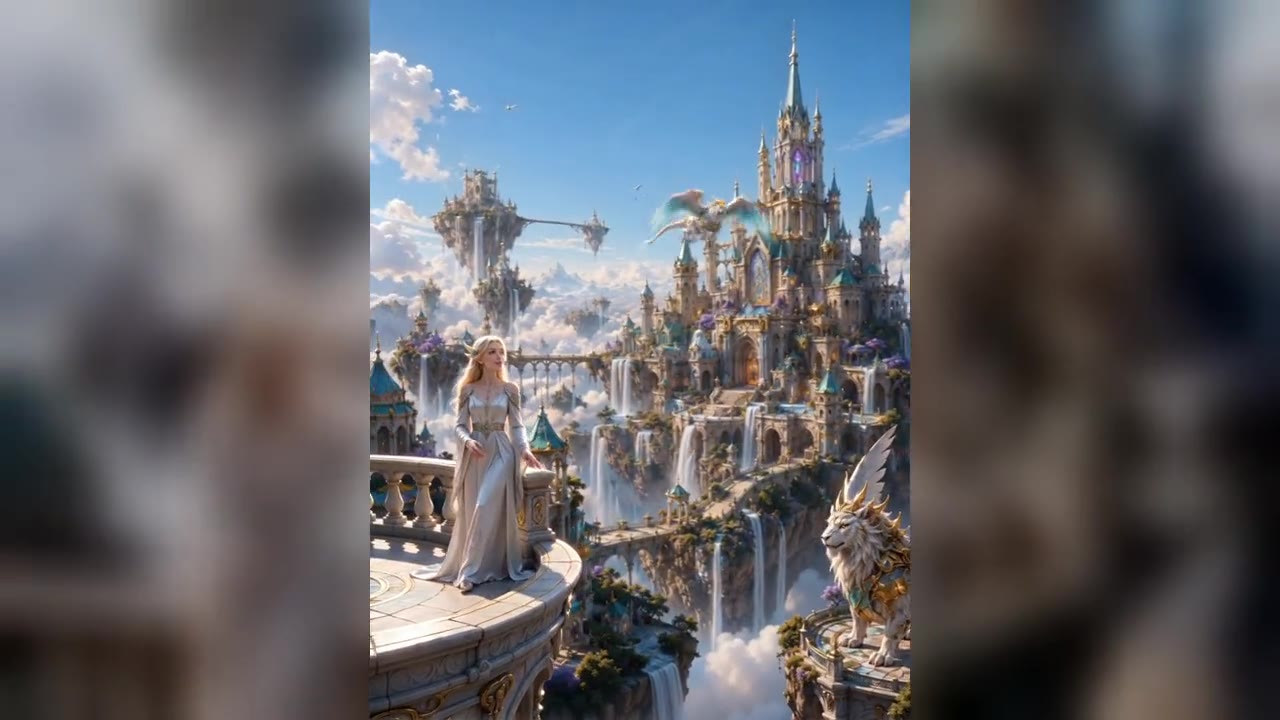
Mit OmniHuman 2.0 wird aus einem einzigen Bild und einer Audiodatei ein realistisches Video mit sprechendem Avatar. Das Modell erweckt Figuren mit natürlicher Sprache, Mimik und Körperbewegung zum Leben – alles vom Audio gesteuert. Erstelle KI-Moderatoren, virtuelle Figuren und digitale Avatare, ganz ohne Dreh. Lade ein Porträtfoto, eine Illustration oder eine stilisierte Figur hoch – Gesicht, Outfit und Stil bleiben deinem Bild treu.
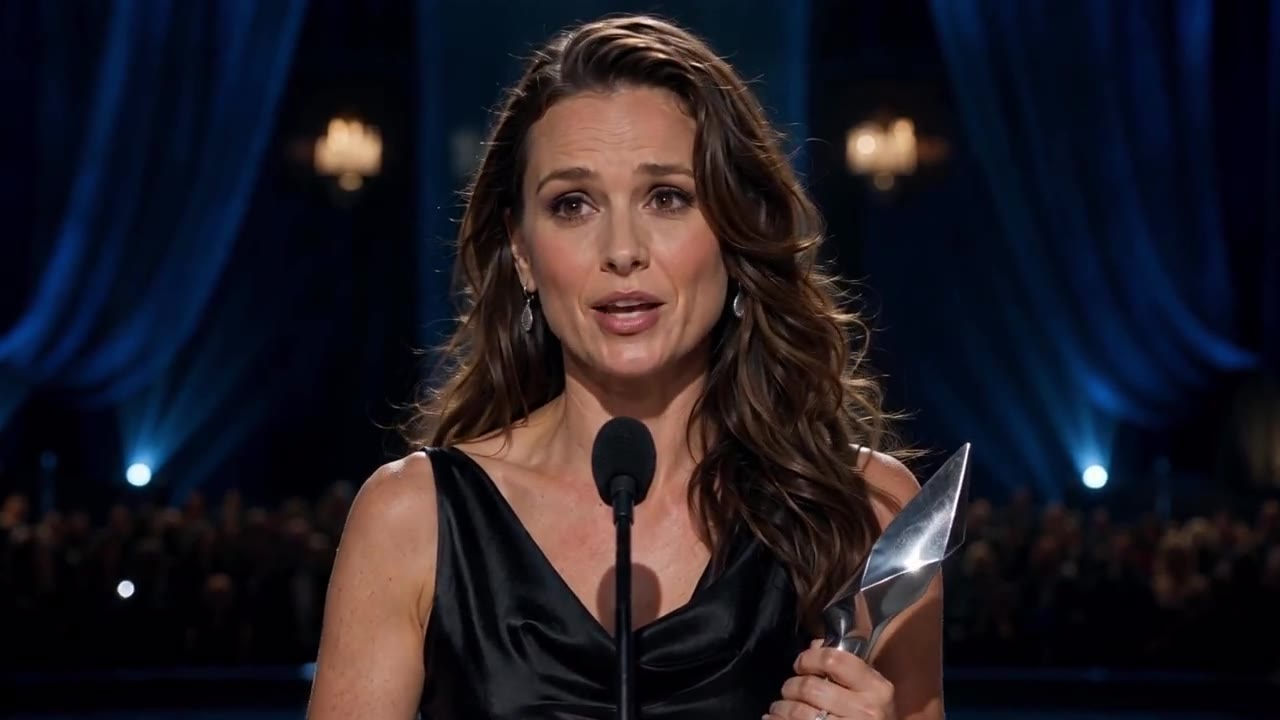
OmniHuman 2.0 erstellt sprechende Videos, deren Lippenbewegungen gesprochenen Worten und Gesang genau folgen. Der Mund bleibt synchron zum Audio, während das übrige Gesicht natürlich in Bewegung bleibt. Ideal für virtuelle Moderatoren, singende Avatare und sprachgesteuerte Figurenanimation. Die Synchronität hält auch in Nahaufnahmen und bei schnellen Songtexten, sodass Talking-Head-Videos und Musikauftritte auf jedem Bildschirm überzeugen.
OmniHuman 2.0 geht über einfache Lippensynchronität hinaus. Es erzeugt Mimik, Kopfbewegungen, Handgesten und Körperbewegung, die auf Rhythmus und Emotion des Audios reagieren. So bekommen KI-Avatare mehr Persönlichkeit für Storytelling, Unterhaltung und Social Media. Eine ruhige Erzählung bleibt sanft, eine aufgeregte Stimme bringt größere Gesten und lebhaftere Mimik.
OmniHuman 2.0 unterstützt sprechende Videos bis 300 Sekunden. Die Länge folgt deinem Audio, von 4 Sekunden bis 5 Minuten. Erstelle komplette Reden, Präsentationen, Tutorials und Songs in einem Durchgang, statt kurze Clips zusammenzuschneiden. Eine durchgehende Einstellung hält Gesicht, Licht und Bildausschnitt vom ersten bis zum letzten Wort gleich.
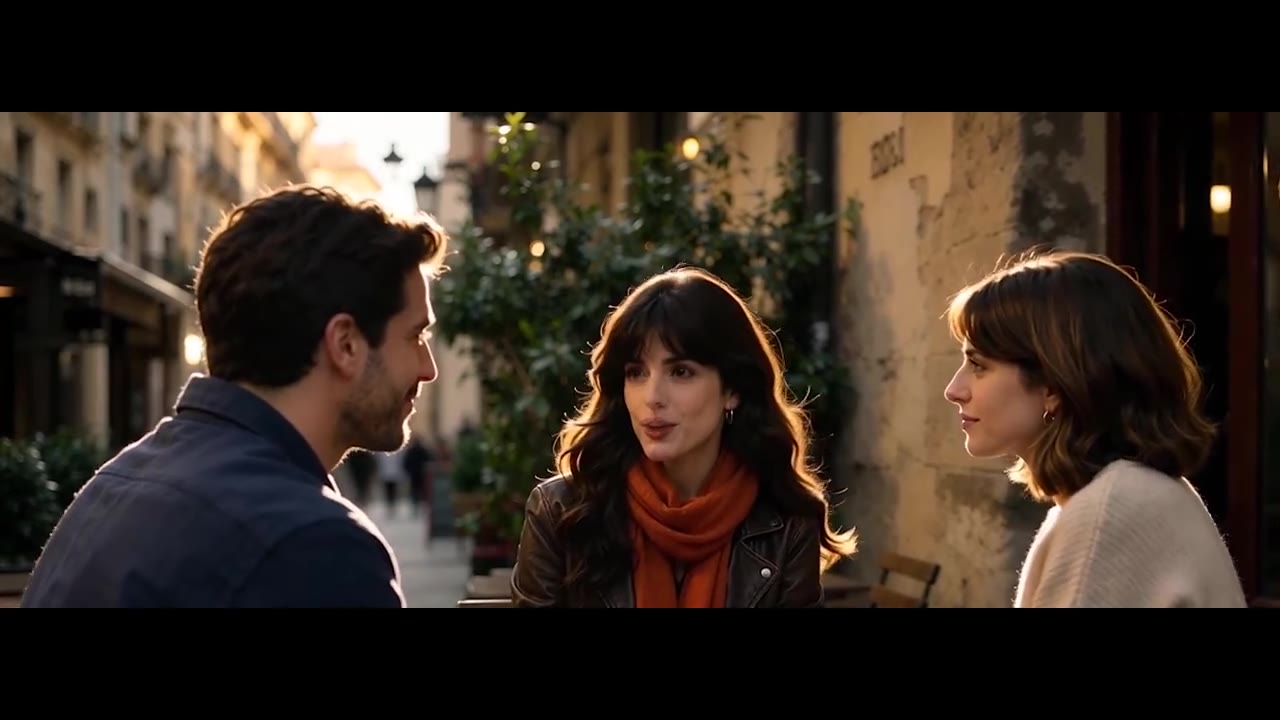
OmniHuman 2.0 kann mehrere Figuren in einer einzigen Szene animieren. Erstelle Gespräche, Interviews und Gruppenauftritte mit audiogesteuerter Mimik und natürlicher Körperbewegung. Mach aus Podcast-Audio und Dialogen packende Videos. Nutze ein Gruppenfoto oder eine Szene mit mehreren Personen und gib jeder sprechenden Person Platz im Bild – so wird das Ergebnis am klarsten.
In OmniHuman 2.0 kannst du Bild und Audio einen optionalen Text-Prompt hinzufügen. Beschreibe Aktionen, Gesten, Szenenverhalten und Kamerabewegung, um das Ergebnis zu formen. Kombiniere audiogesteuerte Animation mit Prompt-Führung für kontrolliertere Videos. Schreib zum Beispiel „lächelt und winkt in die Kamera, langsame Ranfahrt“, um ein Produktvideo mit einem freundlichen Gruß zu eröffnen.
Ein lebensechtes sprechendes Video in OmniHuman 2.0 in drei Schritten:
Melde dich an und öffne den OmniHuman 2.0 Workspace. Lade ein klares JPG-, PNG- oder WEBP-Bild bis 30 MB hoch, 300–6.000 px pro Seite, Seitenverhältnis zwischen 0,4 und 2,5. Fotos, Illustrationen und stilisierte Figuren funktionieren.
Lade Sprache oder Gesang als MP3 oder WAV hoch, bis 15 MB und 4 bis 300 Sekunden lang. Das Audio bestimmt die Videolänge. Optional beschreibst du Gesten, Szene oder Kamera in bis zu 300 Zeichen.
Prüfe das Credit-Angebot und starte. Dein OmniHuman 2.0 Video erscheint im Chat und unter Meine Werke, bereit zur Vorschau und zum Download.
OmniHuman 2.0 erweitert audiogesteuerte Avatare auf Videos bis 5 Minuten – ideal für Präsentationen, Gesang und digitale Menschen. OmniHuman 1.5 erstellt kürzere Clips mit bis zu 1080p. Beide bieten Lippensynchronität, ausdrucksstarke Gesten und Prompt-gesteuerte Animation.
| Funktion | OmniHuman 2.0Bis 5 Min. | OmniHuman 1.5 |
|---|---|---|
| Positionierung | Lange sprechende Avatare | Kurze hochauflösende Clips |
| Eingabe | Bild + Audio + optionaler Prompt | Bild + Audio + optionaler Prompt |
| Audiogesteuerte Animation | Ja | Ja |
| Lippensynchronität | Ja | Ja |
| Mimik | Ja | Ja |
| Körpergesten | Ja | Ja |
| Mehrpersonen-Animation | Ja | Ja |
| Steuerung per Prompt | Ja | Ja |
| Maximale Videolänge | Bis 300 Sekunden | Unter 60 Sekunden |
| Videolänge | Folgt dem Audio, 4–300 s | Folgt dem Audio |
| Ausgabeauflösung | 720p | 720p / 1080p |
| Ideal für | Vorträge, Kurse, Songs und Podcasts | Kurze hochauflösende Avatar-Clips |
OmniHuman 2.0 ist das audiogesteuerte KI-Videomodell von ByteDance. Es macht aus einem Figurenbild und einer Audiodatei ein Video mit sprechendem Avatar – mit synchronen Lippen, Mimik und Gesten. Es funktioniert mit echten Fotos, Illustrationen und stilisierten Figuren und erstellt Videos bis 5 Minuten in 720p.
OmniHuman 2.0 analysiert Sprache, Rhythmus und Emotion im Audio und animiert dein Bild mit passenden Lippenbewegungen, Mimik und Gesten. Ein optionaler Prompt lenkt Aktionen und Kamera. Klare Sprache mit wenig Hintergrundgeräusch ergibt die genaueste Lippensynchronität.
Lade ein JPG-, PNG- oder WEBP-Bild bis 30 MB hoch, 300–6.000 px pro Seite, Seitenverhältnis 0,4 bis 2,5. Audio muss MP3 oder WAV sein, bis 15 MB und 4 bis 300 Sekunden lang. Passt eine Datei nicht, nennt das Upload-Feld den genauen Grund.
OmniHuman 2.0 erstellt Videos von 4 bis 300 Sekunden (5 Minuten). Das Video ist immer so lang wie dein Audio und wird in 720p geliefert.
OmniHuman 2.0 verbraucht 28 Credits pro Sekunde Audio. Ein 10-Sekunden-Video kostet 280 Credits, 1 Minute 1.680 und 5 Minuten 8.400. Den genauen Preis zeigt der Workspace, sobald das Audio hinzugefügt ist. OmniHuman 2.0 erfordert VIP.
Ja. OmniHuman 2.0 kann mehrere Personen in einer Szene animieren – ideal für Interviews, Podcasts und Gruppenauftritte. Das Ergebnis hängt von Bild, Audio und Komplexität der Szene ab. Für das klarste Ergebnis nutze ein Bild, auf dem jedes Gesicht gut sichtbar und beleuchtet ist.
OmniHuman 2.0 erstellt längere Videos bis 300 Sekunden in 720p – ideal für Vorträge, Lektionen und Songs. OmniHuman 1.5 konzentriert sich auf Clips unter 60 Sekunden mit bis zu 1080p. Beide bieten audiogesteuerte Lippensynchronität, Mimik und Gesten.
Ja. Füge einen optionalen Prompt mit bis zu 300 Zeichen hinzu, um Aktionen, Gesten, Szene oder Kamera zu beschreiben. Prompts funktionieren auf Chinesisch, Englisch, Japanisch, Koreanisch, Spanisch und Indonesisch. Die Bewegung folgt außerdem dem Audio.
Ja. Lade einen Song als MP3 oder WAV hoch, und OmniHuman 2.0 synchronisiert Lippen, Atmung und Körperrhythmus mit der Musik. Ideal für virtuelle Sänger, digitale Idols und Musikvideos bis 5 Minuten.
Nutze OmniHuman 2.0 für KI-Moderatoren, Produktwerbung im UGC-Stil, Kurs- und Schulungsvideos, Video-Podcasts, virtuelle Sänger und animierte Illustrationen. Jedes Porträt und jede Sprachaufnahme wird ohne Dreh zum sprechenden Video.
Melde dich an, aktiviere VIP und öffne den OmniHuman 2.0 Workspace auf dieser Seite. Lade ein Porträt und dein Audio hoch, füge bei Bedarf einen Prompt hinzu und starte. Kein Code, keine Installation. Dein erstes sprechendes Video kann in wenigen Minuten fertig sein.