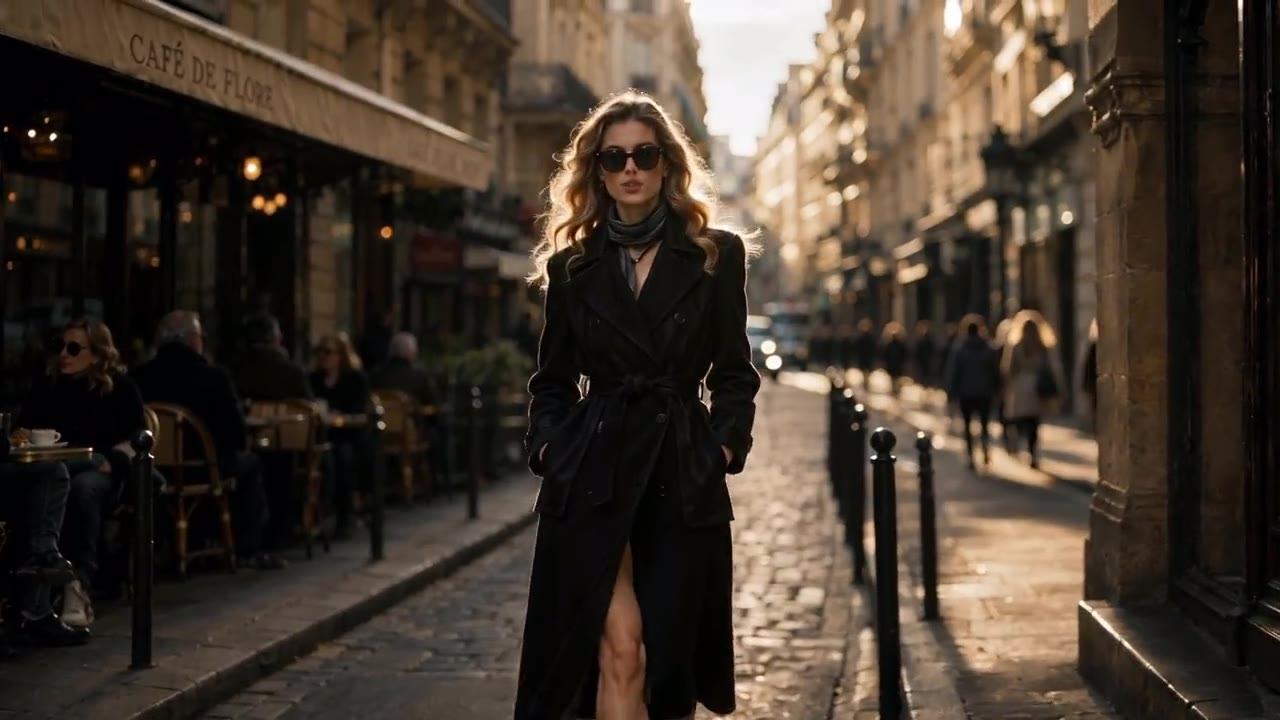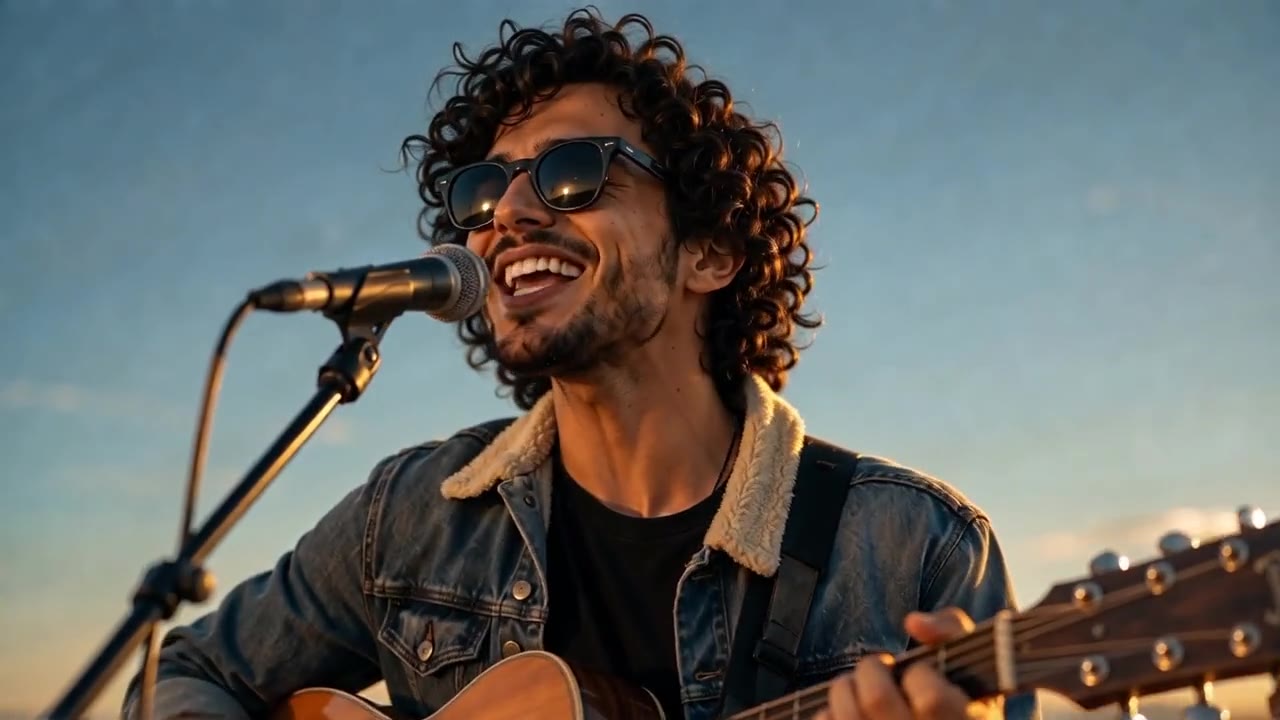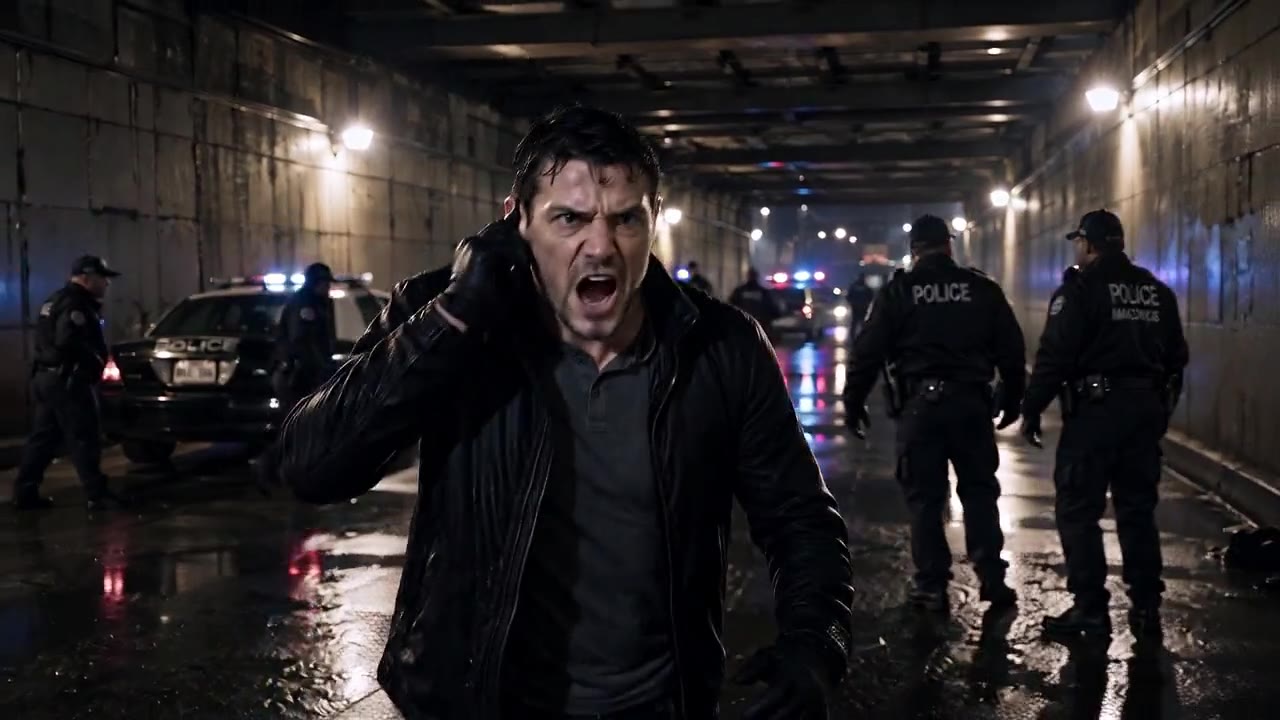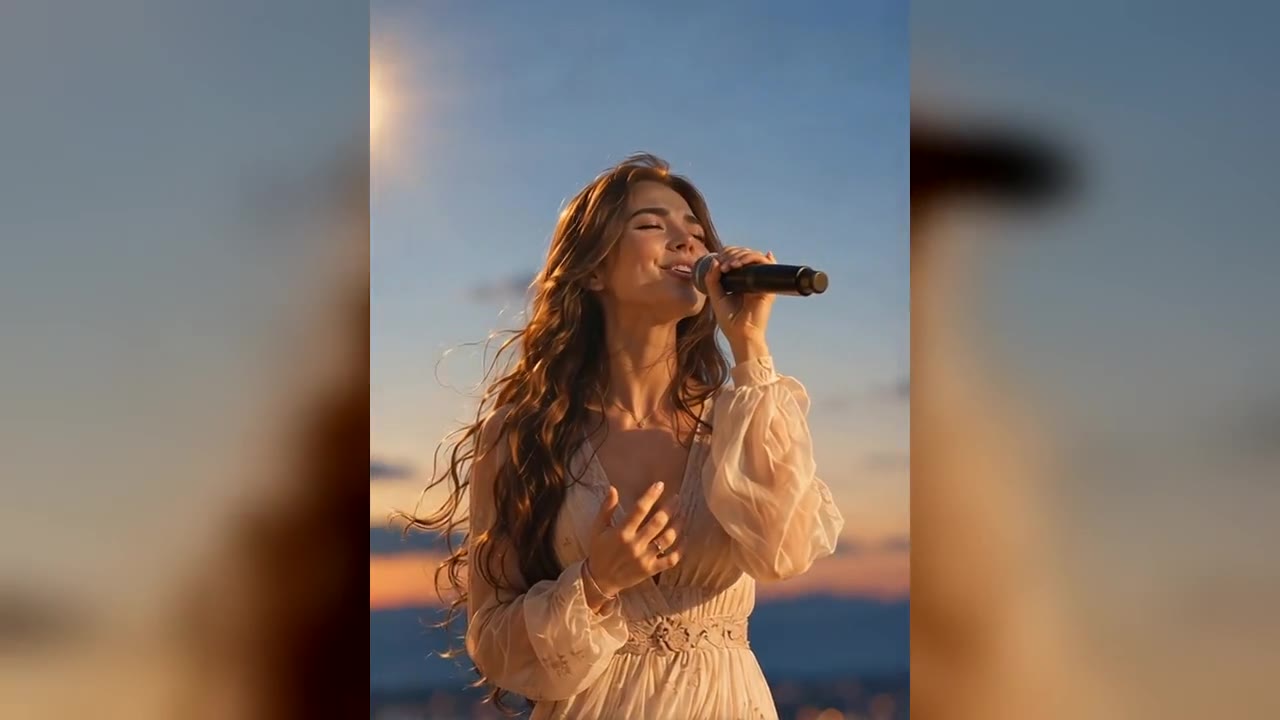
OmniHuman 2.0 数字人说话视频
上传一张人像和 4–300 秒的 MP3 或 WAV 音频,生成与音频等长的 720p 视频。可加最多 300 字的提示词,引导手势与镜头。
打开工作台OmniHuman 2.0 是一款音频驱动的 AI 视频模型,用一张图片和一段音频生成逼真的数字人说话视频,口型同步自然,表情与肢体动作丰富,视频最长 5 分钟。
图片 + 音频生成视频 · 720p · 4–300 秒 · 可选提示词
一个工作流:上传人像,加入语音或歌声,可选描述表演方式。
上传一张人像和 4–300 秒的 MP3 或 WAV 音频,生成与音频等长的 720p 视频。可加最多 300 字的提示词,引导手势与镜头。
打开工作台OmniHuman 2.0 用一张图片和你的音频生成说话视频,口型同步自然,表情与肢体动作生动。
用 OmniHuman 2.0,把一张图片和一段音频变成逼真的数字人说话视频。角色的语言、表情和肢体动作都由音频驱动,自然生动。无需真人出镜,即可打造 AI 主持人、虚拟角色与数字人。无论是人像照片、插画还是风格化角色,OmniHuman 2.0 都会忠实保留原图的面孔、服装与画风。
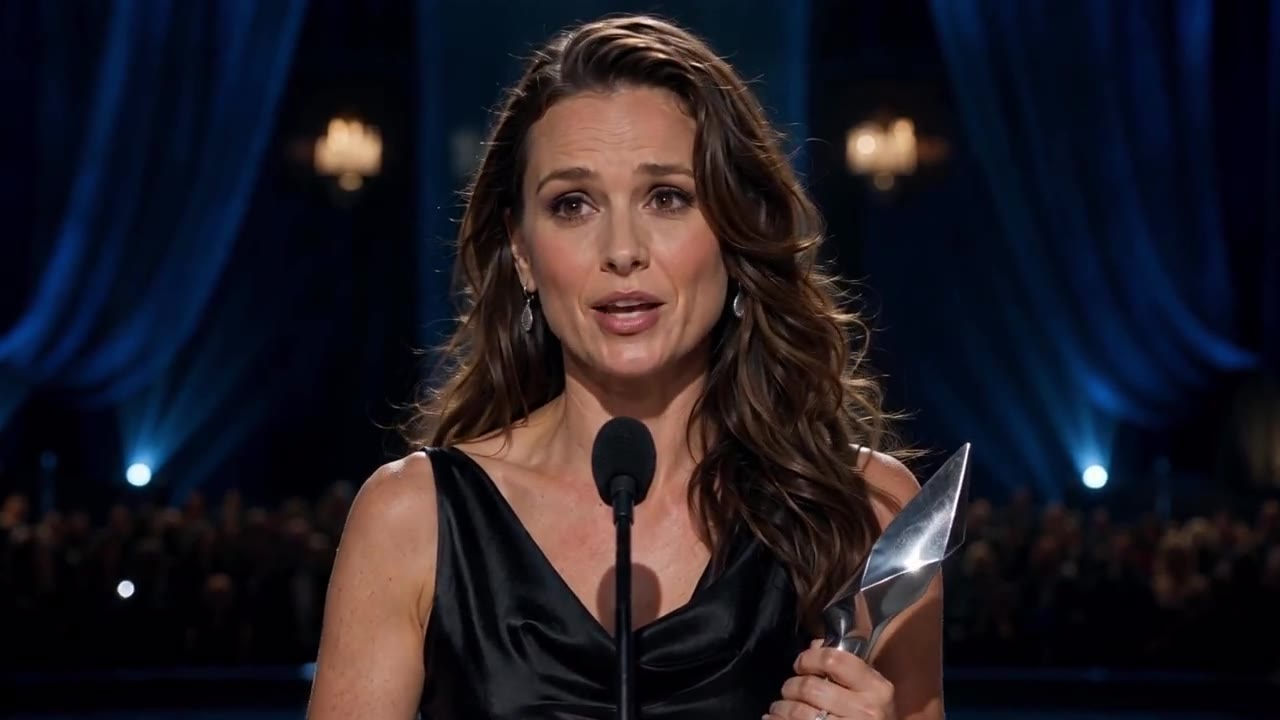
OmniHuman 2.0 生成的说话视频,口型紧贴说出的每个字和唱出的每句歌词。嘴型与音频保持同步,面部其他部位依旧自然灵动。适用于虚拟主持人、歌唱数字人和语音驱动的角色动画。无论是近景特写还是快节奏歌词,OmniHuman 2.0 的口型都稳稳跟上,口播视频和音乐表演在任何屏幕上都真实可信。
OmniHuman 2.0 不止于基础口型同步。它会根据音频的节奏和情绪,生成相应的面部表情、转头、手势和身体动作。让数字人更有个性,适合故事讲述、娱乐和社交媒体内容。在 OmniHuman 2.0 中,平静的旁白让动作温和克制,激动的声音则带来更大的手势和更鲜活的表情。
OmniHuman 2.0 支持最长 300 秒的说话视频。视频时长跟随音频,从 4 秒到 5 分钟都可以。完整的演讲、讲解、教程和歌曲一次生成,不用再拼接零碎短片。OmniHuman 2.0 一镜到底,从第一个字到最后一个字,面孔、光线和构图始终如一。
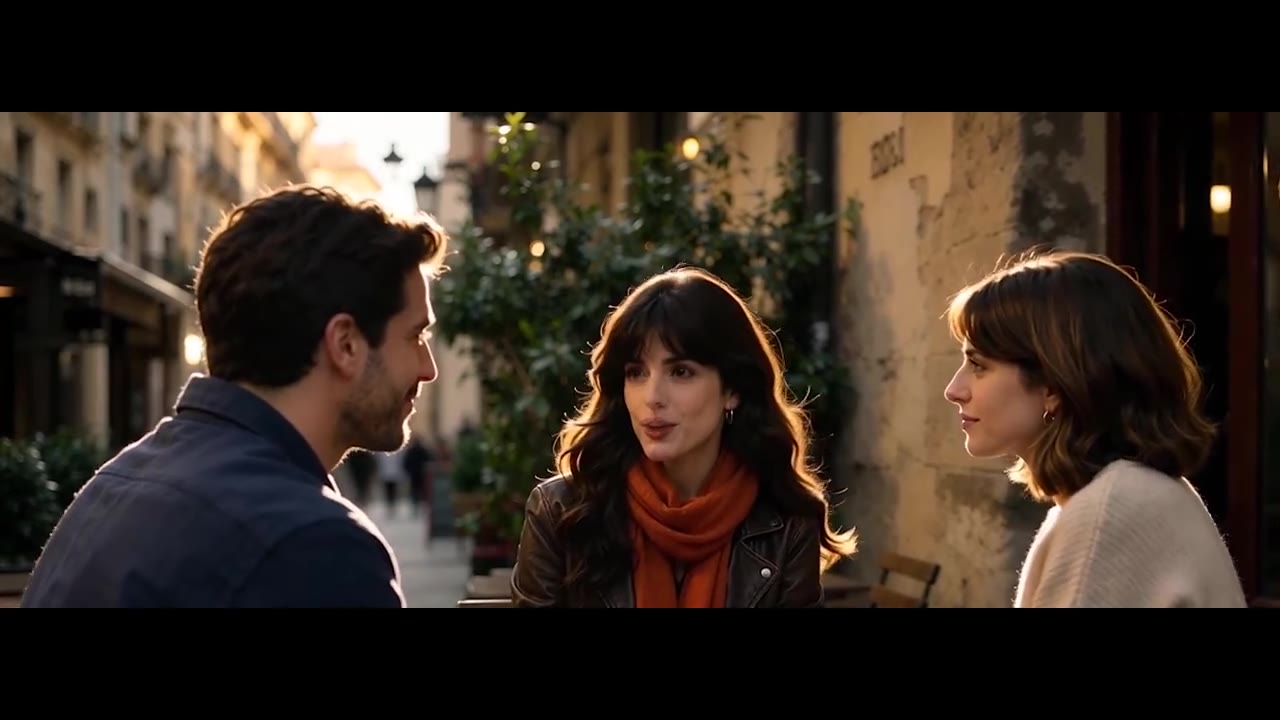
OmniHuman 2.0 能在同一个画面中驱动多个角色。用音频驱动表情与自然的肢体动作,生成对话、访谈和群体表演。把播客音频和对白变成引人入胜的视频。使用合影或多人场景图片,并让每位说话者在画面中都有清晰的位置,效果最好。
在 OmniHuman 2.0 中,你可以在图片和音频之外加一段可选的文字提示词。描述动作、手势、场景表现和镜头运动,塑造想要的效果。音频驱动加上提示词引导,说话视频更可控。例如写下“对着镜头微笑挥手,镜头缓慢推近”,就能为产品视频加上一个亲切的开场。
只需三个简单步骤,即可在 OmniHuman 2.0 中生成逼真的说话视频:
登录后打开 OmniHuman 2.0 工作台。上传 1 张清晰的 JPG、PNG 或 WEBP 图片,不超过 30MB,每边 300–6,000px,宽高比 0.4–2.5。照片、插画和风格化角色都可以。
上传 MP3 或 WAV 格式的语音或歌声,不超过 15MB,时长 4–300 秒,视频时长由音频决定。如有需要,可用最多 300 字描述手势、场景或镜头运动。
确认积分报价后开始生成。OmniHuman 2.0 视频会出现在对话和“我的作品”中,可随时预览和下载。
OmniHuman 2.0 把音频驱动数字人扩展到最长 5 分钟,适合演讲、歌唱与数字人应用。OmniHuman 1.5 适合较短片段,最高 1080p 输出。两者都支持口型同步、丰富手势和提示词引导动画。
| 功能 | OmniHuman 2.0最长 5 分钟 | OmniHuman 1.5 |
|---|---|---|
| 产品定位 | 长时长数字人视频 | 短时高清片段 |
| 输入 | 图片 + 音频 + 可选提示词 | 图片 + 音频 + 可选提示词 |
| 音频驱动动画 | 支持 | 支持 |
| 口型同步 | 支持 | 支持 |
| 面部表情 | 支持 | 支持 |
| 肢体动作 | 支持 | 支持 |
| 多人动画 | 支持 | 支持 |
| 文字提示词控制 | 支持 | 支持 |
| 最长视频时长 | 最长 300 秒 | 60 秒以内 |
| 视频时长 | 跟随音频,4–300 秒 | 跟随音频 |
| 输出分辨率 | 720p | 720p / 1080p |
| 最佳适用场景 | 演讲、课程、歌曲与播客 | 短时高清数字人片段 |
OmniHuman 2.0 是字节跳动推出的音频驱动 AI 视频模型。它把一张角色图片和一段音频变成数字人说话视频,口型、面部表情与肢体动作全部同步。OmniHuman 2.0 适用于真实照片、插画和风格化角色,可生成最长 5 分钟的 720p 视频。
OmniHuman 2.0 会分析音频中的语音、节奏和情绪,再让图片中的角色做出对应的口型、表情和肢体动作。还可以用可选的文字提示词引导动作和镜头运动。人声清晰、背景噪音少的音频,口型同步最准确。
上传 1 张 JPG、PNG 或 WEBP 图片,不超过 30MB,每边 300–6,000px,宽高比 0.4–2.5。音频需为 MP3 或 WAV,不超过 15MB,时长 4–300 秒。文件不符合要求时,上传框会直接告诉你原因。
OmniHuman 2.0 可生成 4 到 300 秒(5 分钟)的视频。视频时长始终与音频一致,以 720p 输出。
OmniHuman 2.0 按音频时长计费,每秒 28 积分。10 秒视频 280 积分,1 分钟 1,680 积分,5 分钟 8,400 积分。添加音频后,工作台会显示准确报价。OmniHuman 2.0 需要开通 VIP。
支持。OmniHuman 2.0 能在同一画面中驱动多个人物,很适合访谈、播客和群体表演。效果取决于图片、音频和场景复杂度。想要最清晰的效果,请使用每张脸都清楚可见、光线充足的图片。
OmniHuman 2.0 可生成最长 300 秒的 720p 视频,适合演讲、课程和歌曲。OmniHuman 1.5 侧重 60 秒以内、最高 1080p 的片段。两者都支持音频驱动的口型同步、表情与手势。
可以。添加最多 300 字的可选提示词,描述动作、手势、场景或镜头运动。提示词支持中文、英语、日语、韩语、西班牙语和印尼语。最终动作同样会跟随音频。
可以。上传 MP3 或 WAV 歌曲,OmniHuman 2.0 会让口型、呼吸和身体律动跟上音乐。适合虚拟歌手、数字偶像和最长 5 分钟的音乐视频。
OmniHuman 2.0 可用于 AI 主持人、UGC 风格产品广告、课程与培训视频、可视化播客、虚拟歌手和插画动画。任何人像加一段录音,都能变成说话视频,无需拍摄。
登录并开通 VIP,从本页打开 OmniHuman 2.0 工作台。上传人像和音频,按需添加提示词,然后生成。无需写代码,也无需安装软件。几分钟内,你的第一支说话视频就能完成。