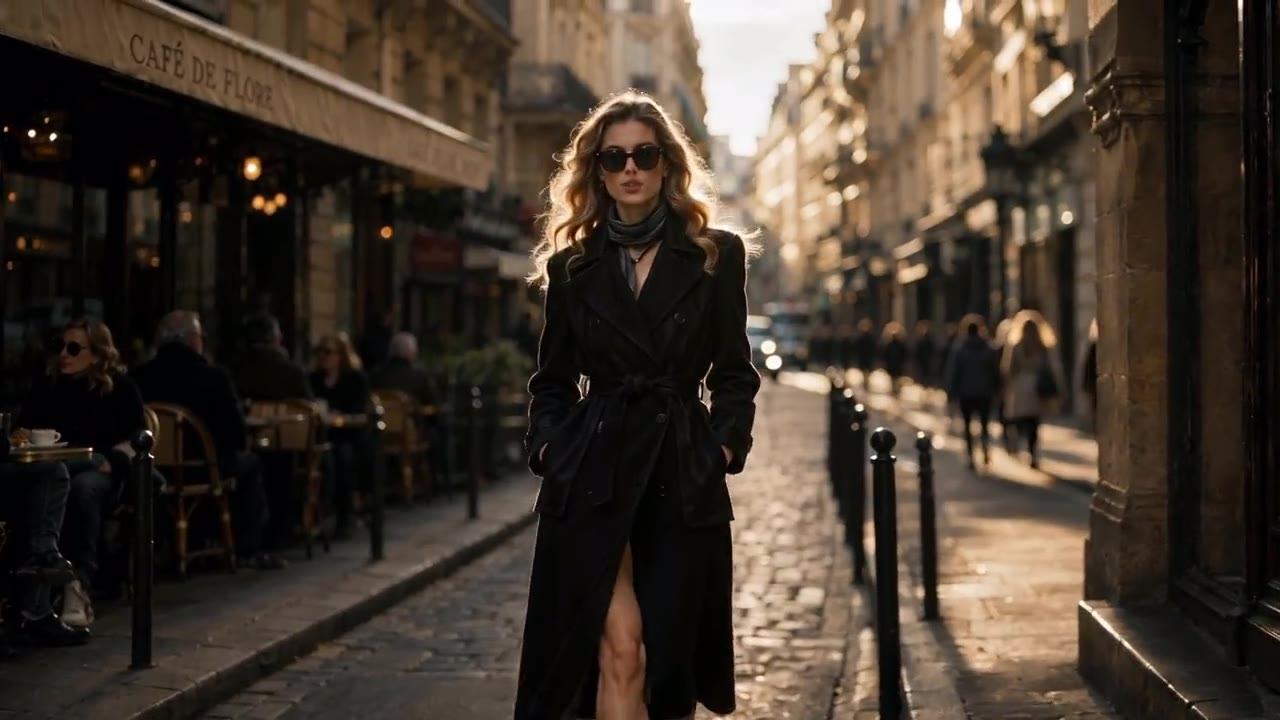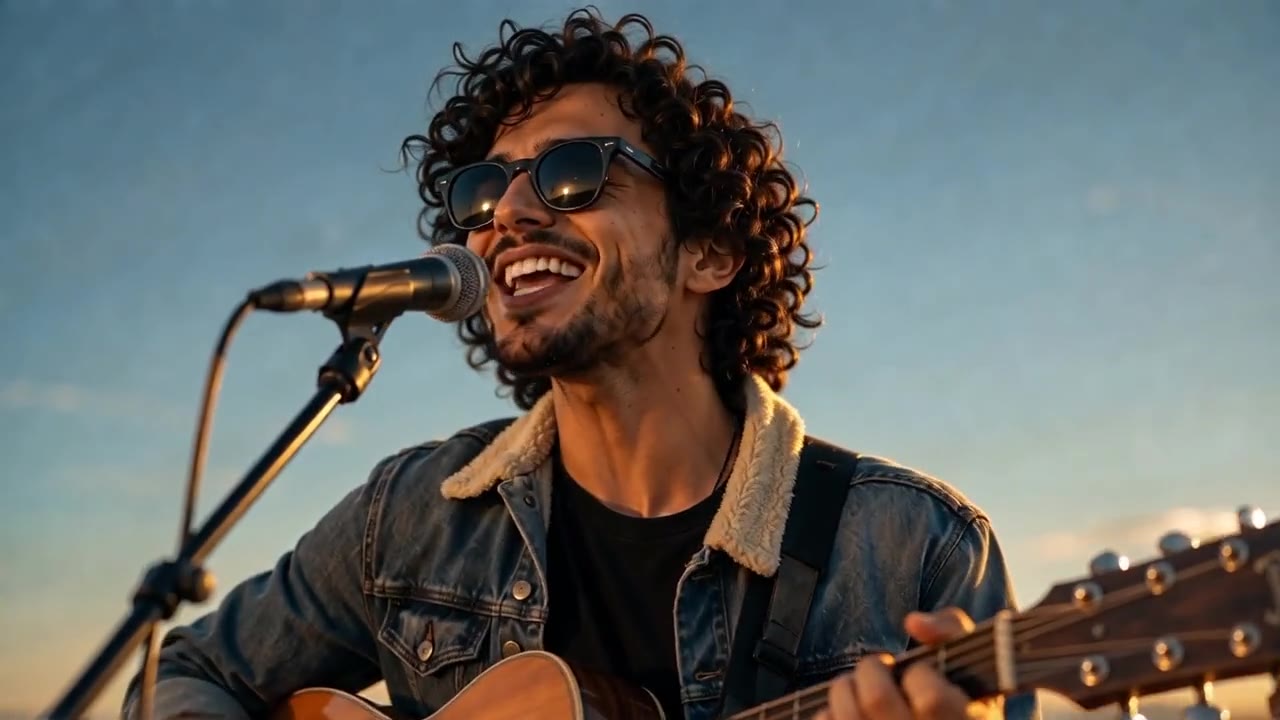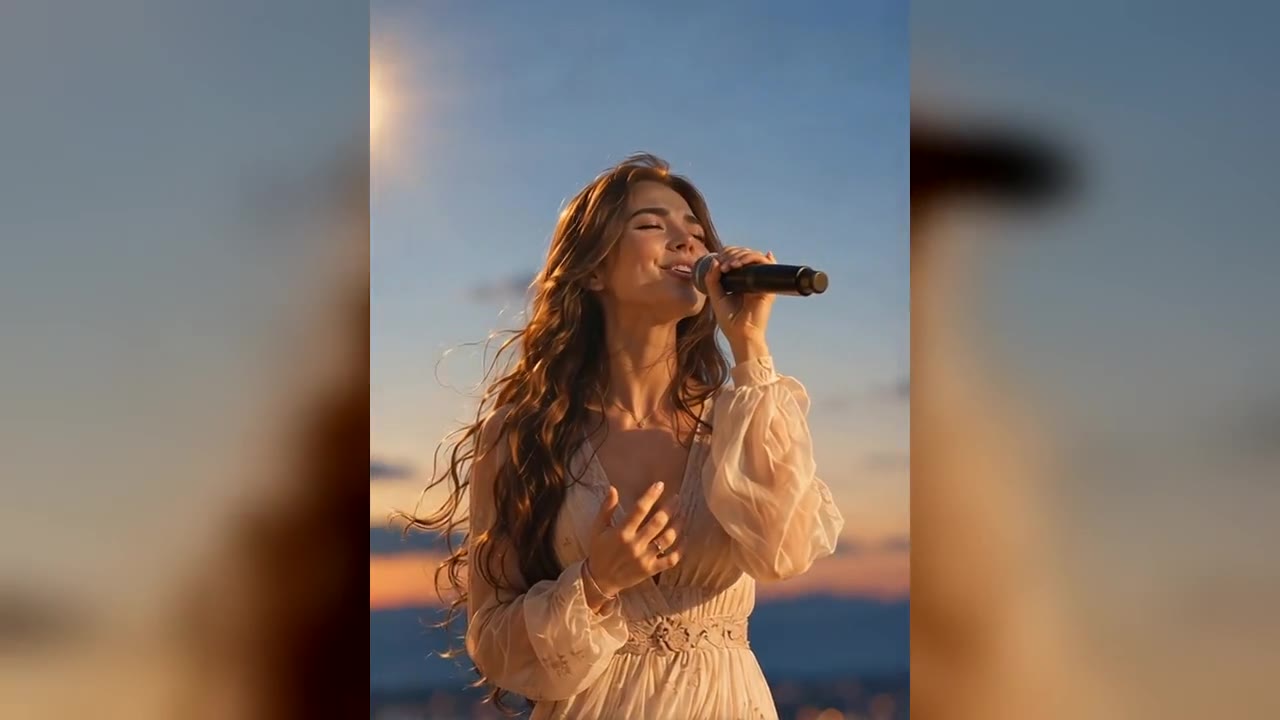
OmniHuman 2.0 數字人說話影片
上傳一張人像和 4–300 秒的 MP3 或 WAV 音訊,生成與音訊等長的 720p 影片。可加最多 300 字的提示詞,引導手勢與鏡頭。
打開工作台OmniHuman 2.0 是一款音訊驅動的 AI 影片模型,用一張圖片和一段音訊生成逼真的數字人說話影片,口型同步自然,表情與肢體動作豐富,影片最長 5 分鐘。
圖片 + 音訊生成影片 · 720p · 4–300 秒 · 可選提示詞
一個工作流:上傳人像,加入語音或歌聲,可選描述表演方式。
上傳一張人像和 4–300 秒的 MP3 或 WAV 音訊,生成與音訊等長的 720p 影片。可加最多 300 字的提示詞,引導手勢與鏡頭。
打開工作台OmniHuman 2.0 用一張圖片和你的音訊生成說話影片,口型同步自然,表情與肢體動作生動。
用 OmniHuman 2.0,把一張圖片和一段音訊變成逼真的數字人說話影片。角色的語言、表情和肢體動作都由音訊驅動,自然生動。無需真人出鏡,即可打造 AI 主持人、虛擬角色與數字人。無論是人像照片、插畫還是風格化角色,OmniHuman 2.0 都會忠實保留原圖的面孔、服裝與畫風。
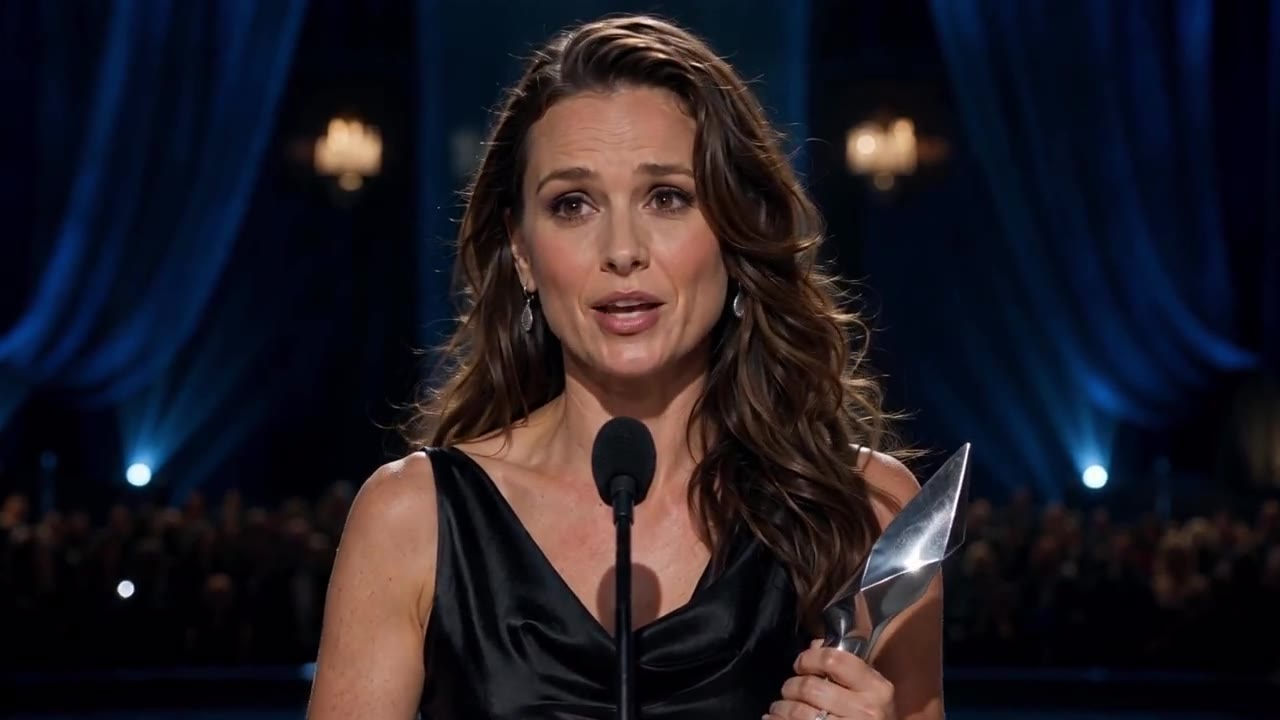
OmniHuman 2.0 生成的說話影片,口型緊貼說出的每個字和唱出的每句歌詞。嘴型與音訊保持同步,面部其他部位依舊自然靈動。適用於虛擬主持人、歌唱數字人和語音驅動的角色動畫。無論是近景特寫還是快節奏歌詞,OmniHuman 2.0 的口型都穩穩跟上,口播影片和音樂表演在任何螢幕上都真實可信。
OmniHuman 2.0 不止於基礎口型同步。它會根據音訊的節奏和情緒,生成相應的面部表情、轉頭、手勢和身體動作。讓數字人更有個性,適合故事講述、娛樂和社交媒體內容。在 OmniHuman 2.0 中,平靜的旁白讓動作溫和剋制,激動的聲音則帶來更大的手勢和更鮮活的表情。
OmniHuman 2.0 支援最長 300 秒的說話影片。影片時長跟隨音訊,從 4 秒到 5 分鐘都可以。完整的演講、講解、教程和歌曲一次生成,不用再拼接零碎短片。OmniHuman 2.0 一鏡到底,從第一個字到最後一個字,面孔、光線和構圖始終如一。
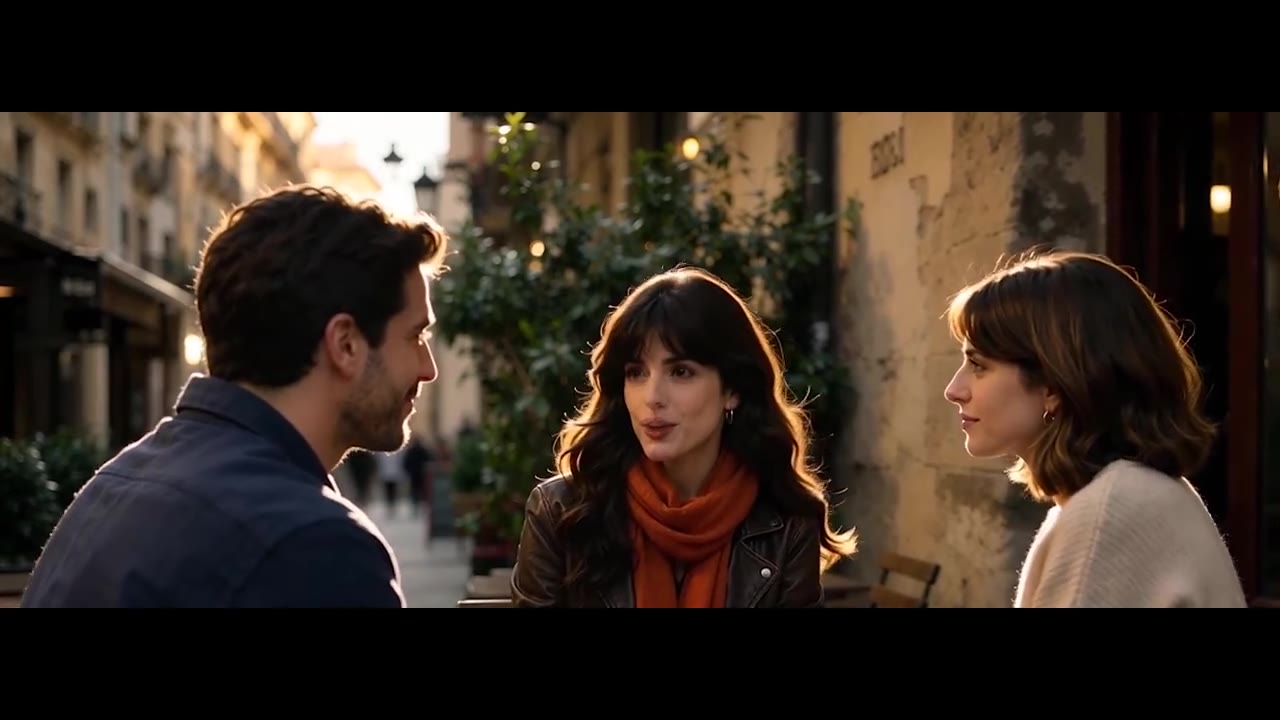
OmniHuman 2.0 能在同一個畫面中驅動多個角色。用音訊驅動表情與自然的肢體動作,生成對話、訪談和群體表演。把播客音訊和對白變成引人入勝的影片。使用合影或多人場景圖片,並讓每位說話者在畫面中都有清晰的位置,效果最好。
在 OmniHuman 2.0 中,你可以在圖片和音訊之外加一段可選的文字提示詞。描述動作、手勢、場景表現和鏡頭運動,塑造想要的效果。音訊驅動加上提示詞引導,說話影片更可控。例如寫下“對著鏡頭微笑揮手,鏡頭緩慢推近”,就能為產品影片加上一個親切的開場。
只需三個簡單步驟,即可在 OmniHuman 2.0 中生成逼真的說話影片:
登入後開啟 OmniHuman 2.0 工作臺。上傳 1 張清晰的 JPG、PNG 或 WEBP 圖片,不超過 30MB,每邊 300–6,000px,寬高比 0.4–2.5。照片、插畫和風格化角色都可以。
上傳 MP3 或 WAV 格式的語音或歌聲,不超過 15MB,時長 4–300 秒,影片時長由音訊決定。如有需要,可用最多 300 字描述手勢、場景或鏡頭運動。
確認積分報價後開始生成。OmniHuman 2.0 影片會出現在對話和“我的作品”中,可隨時預覽和下載。
OmniHuman 2.0 把音訊驅動數字人擴充套件到最長 5 分鐘,適合演講、歌唱與數字人應用。OmniHuman 1.5 適合較短片段,最高 1080p 輸出。兩者都支援口型同步、豐富手勢和提示詞引導動畫。
| 功能 | OmniHuman 2.0最長 5 分鐘 | OmniHuman 1.5 |
|---|---|---|
| 產品定位 | 長時長數字人影片 | 短時高畫質片段 |
| 輸入 | 圖片 + 音訊 + 可選提示詞 | 圖片 + 音訊 + 可選提示詞 |
| 音訊驅動動畫 | 支援 | 支援 |
| 口型同步 | 支援 | 支援 |
| 面部表情 | 支援 | 支援 |
| 肢體動作 | 支援 | 支援 |
| 多人動畫 | 支援 | 支援 |
| 文字提示詞控制 | 支援 | 支援 |
| 最長影片時長 | 最長 300 秒 | 60 秒以內 |
| 影片時長 | 跟隨音訊,4–300 秒 | 跟隨音訊 |
| 輸出解析度 | 720p | 720p / 1080p |
| 最佳適用場景 | 演講、課程、歌曲與播客 | 短時高畫質數字人片段 |
OmniHuman 2.0 是位元組跳動推出的音訊驅動 AI 影片模型。它把一張角色圖片和一段音訊變成數字人說話影片,口型、面部表情與肢體動作全部同步。OmniHuman 2.0 適用於真實照片、插畫和風格化角色,可生成最長 5 分鐘的 720p 影片。
OmniHuman 2.0 會分析音訊中的語音、節奏和情緒,再讓圖片中的角色做出對應的口型、表情和肢體動作。還可以用可選的文字提示詞引導動作和鏡頭運動。人聲清晰、背景噪音少的音訊,口型同步最準確。
上傳 1 張 JPG、PNG 或 WEBP 圖片,不超過 30MB,每邊 300–6,000px,寬高比 0.4–2.5。音訊需為 MP3 或 WAV,不超過 15MB,時長 4–300 秒。檔案不符合要求時,上傳框會直接告訴你原因。
OmniHuman 2.0 可生成 4 到 300 秒(5 分鐘)的影片。影片時長始終與音訊一致,以 720p 輸出。
OmniHuman 2.0 按音訊時長計費,每秒 28 積分。10 秒影片 280 積分,1 分鐘 1,680 積分,5 分鐘 8,400 積分。新增音訊後,工作臺會顯示準確報價。OmniHuman 2.0 需要開通 VIP。
支援。OmniHuman 2.0 能在同一畫面中驅動多個人物,很適合訪談、播客和群體表演。效果取決於圖片、音訊和場景複雜度。想要最清晰的效果,請使用每張臉都清楚可見、光線充足的圖片。
OmniHuman 2.0 可生成最長 300 秒的 720p 影片,適合演講、課程和歌曲。OmniHuman 1.5 側重 60 秒以內、最高 1080p 的片段。兩者都支援音訊驅動的口型同步、表情與手勢。
可以。新增最多 300 字的可選提示詞,描述動作、手勢、場景或鏡頭運動。提示詞支援中文、英語、日語、韓語、西班牙語和印尼語。最終動作同樣會跟隨音訊。
可以。上傳 MP3 或 WAV 歌曲,OmniHuman 2.0 會讓口型、呼吸和身體律動跟上音樂。適合虛擬歌手、數字偶像和最長 5 分鐘的音樂影片。
OmniHuman 2.0 可用於 AI 主持人、UGC 風格產品廣告、課程與培訓影片、視覺化播客、虛擬歌手和插畫動畫。任何人像加一段錄音,都能變成說話影片,無需拍攝。
登入並開通 VIP,從本頁開啟 OmniHuman 2.0 工作臺。上傳人像和音訊,按需新增提示詞,然後生成。無需寫程式碼,也無需安裝軟體。幾分鐘內,你的第一支說話影片就能完成。