Avatar falante OmniHuman 2.0
Envie um retrato e de 4 a 300 segundos de áudio MP3 ou WAV. O vídeo 720p segue a duração do áudio. Adicione um prompt opcional de até 300 caracteres para guiar gestos e câmera.
Abrir espaço de trabalhoO OmniHuman 2.0 é um modelo de vídeo com IA guiado por áudio que transforma uma imagem e um áudio em um vídeo realista de avatar falante, com sincronia labial natural, rostos expressivos, gestos corporais e até 5 minutos de duração.
Imagem + áudio para vídeo · 720p · 4–300 segundos · prompt opcional
Um só fluxo: envie um retrato, adicione fala ou canto e, se quiser, descreva a atuação.
Envie um retrato e de 4 a 300 segundos de áudio MP3 ou WAV. O vídeo 720p segue a duração do áudio. Adicione um prompt opcional de até 300 caracteres para guiar gestos e câmera.
Abrir espaço de trabalhoO OmniHuman 2.0 transforma uma imagem e o seu áudio em um vídeo falante com sincronia labial natural, expressões e gestos.
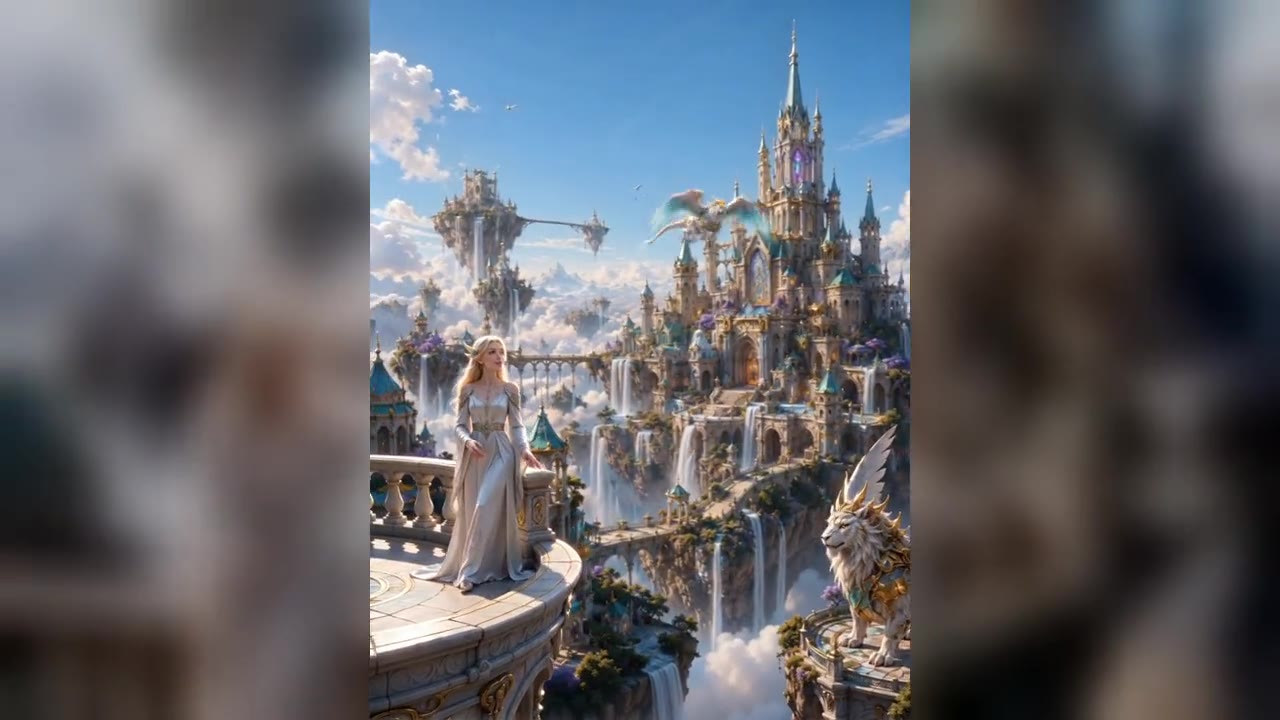
Com o OmniHuman 2.0, uma única imagem e um arquivo de áudio viram um vídeo realista de avatar falante. O modelo dá vida aos personagens com fala, expressões faciais e movimentos corporais naturais, tudo guiado pelo áudio. Crie apresentadores com IA, personagens virtuais e avatares digitais sem filmar ninguém. Envie uma foto, uma ilustração ou um personagem estilizado, e o rosto, a roupa e o estilo continuam fiéis à sua imagem.
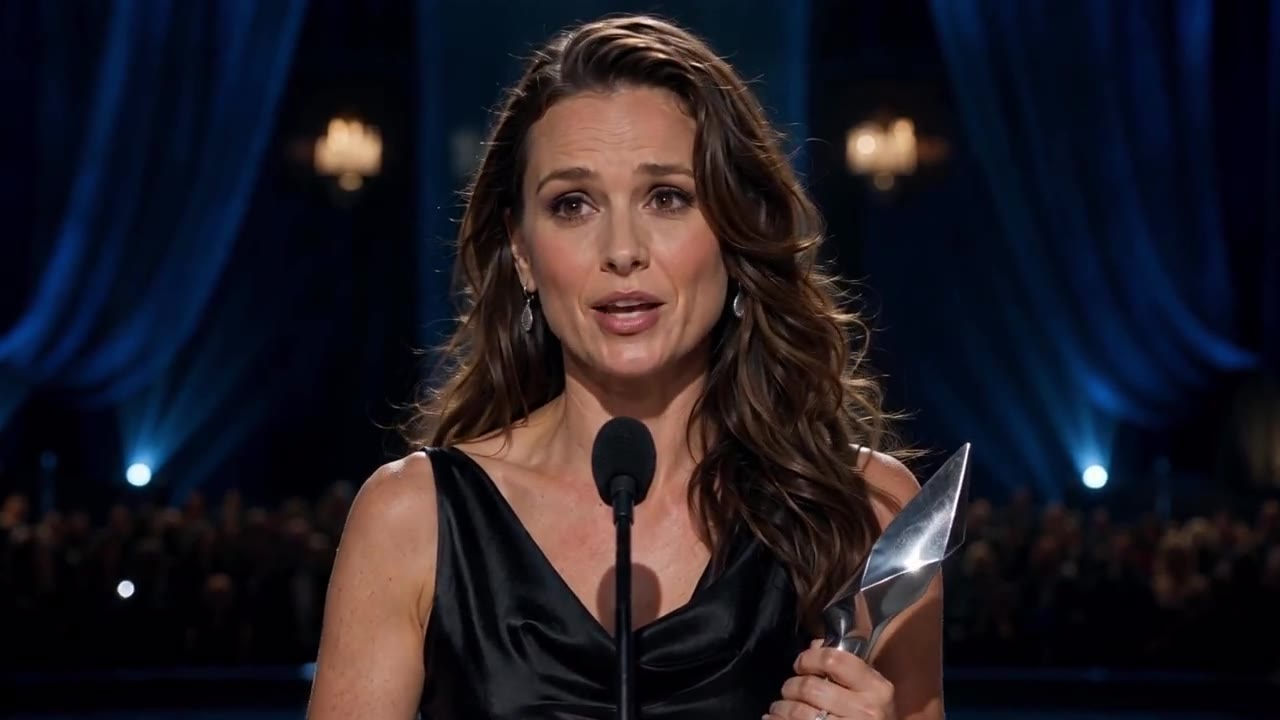
O OmniHuman 2.0 cria vídeos falantes com movimentos labiais que acompanham de perto as palavras e o canto. A boca fica sincronizada com o áudio enquanto o resto do rosto se move com naturalidade. Use para apresentadores virtuais, avatares que cantam e animação de personagens guiada por voz. A sincronia do OmniHuman 2.0 se mantém em closes e em letras rápidas, então vídeos falando para a câmera e apresentações musicais convencem em qualquer tela.
O OmniHuman 2.0 vai além da sincronia labial básica. Ele gera expressões faciais, movimentos de cabeça, gestos com as mãos e movimento corporal que respondem ao ritmo e à emoção do áudio. Dê mais personalidade aos avatares para histórias, entretenimento e redes sociais. Uma narração calma fica suave, enquanto uma voz animada traz gestos maiores e expressões mais vivas.
O OmniHuman 2.0 suporta vídeos falantes de até 300 segundos. A duração segue o seu áudio, de 4 segundos a 5 minutos. Produza discursos, apresentações, tutoriais e músicas completos de uma vez, sem juntar clipes curtos. Uma única tomada contínua do OmniHuman 2.0 mantém o mesmo rosto, a mesma luz e o mesmo enquadramento da primeira à última palavra.
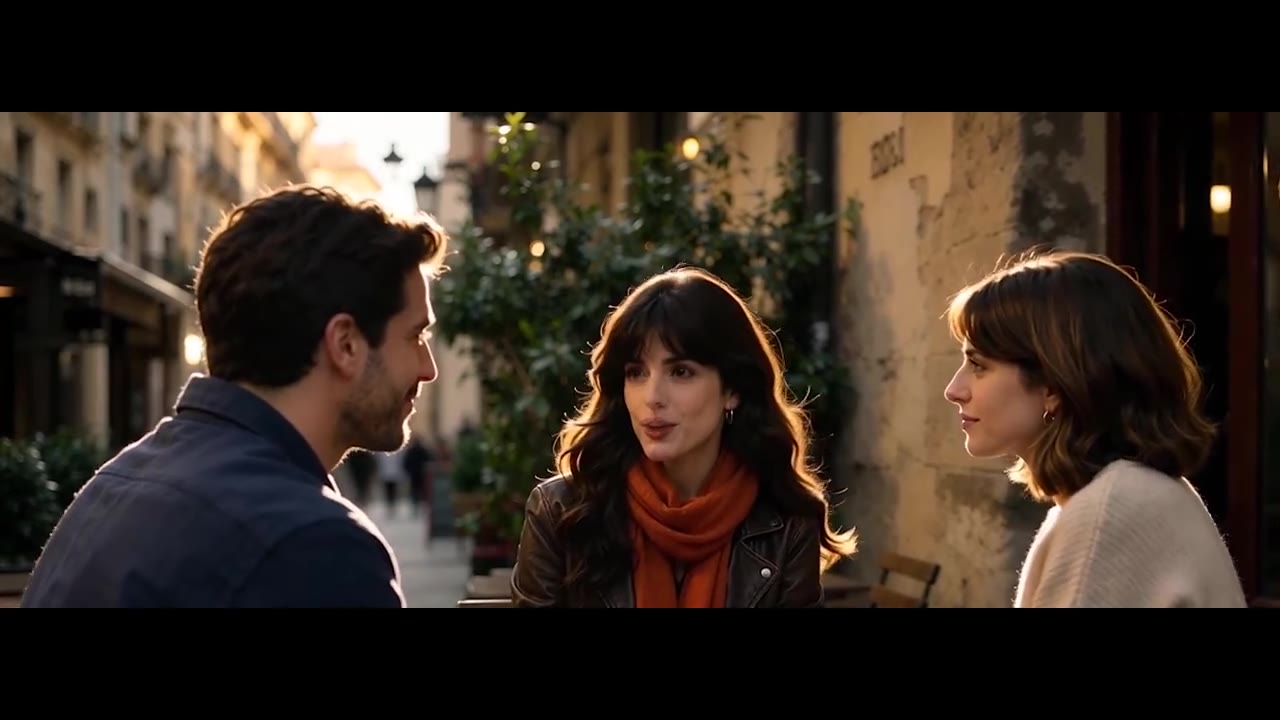
O OmniHuman 2.0 pode animar vários personagens em uma única cena. Crie conversas, entrevistas e apresentações em grupo com expressões guiadas pelo áudio e movimento corporal natural. Transforme podcasts e diálogos em vídeos envolventes. Use uma foto em grupo ou uma cena com várias pessoas e deixe espaço para cada falante no quadro para um resultado mais claro.
No OmniHuman 2.0, adicione um prompt de texto opcional à imagem e ao áudio. Descreva ações, gestos, comportamento da cena e movimento de câmera para moldar o resultado. Combine a animação guiada por áudio com o prompt para vídeos mais controlados. Por exemplo, escreva “sorri e acena para a câmera, aproximação lenta” para abrir um vídeo de produto com uma saudação simpática.
Crie um vídeo falante realista no OmniHuman 2.0 em três passos:
Entre e abra o espaço do OmniHuman 2.0. Envie uma imagem JPG, PNG ou WEBP nítida de até 30 MB, com 300 a 6.000 px por lado e proporção entre 0,4 e 2,5. Fotos, ilustrações e personagens estilizados funcionam.
Envie fala ou canto em MP3 ou WAV, até 15 MB e de 4 a 300 segundos. O áudio define a duração do vídeo. Se quiser, descreva gestos, cena ou câmera em até 300 caracteres.
Confira o orçamento de créditos e gere. Seu vídeo do OmniHuman 2.0 aparece na conversa e em Minhas criações, pronto para ver e baixar.
O OmniHuman 2.0 leva os avatares guiados por áudio a vídeos de até 5 minutos, ideais para apresentações, canto e humanos digitais. O OmniHuman 1.5 cria clipes mais curtos com saída de até 1080p. Ambos suportam sincronia labial, gestos expressivos e animação guiada por prompt.
| Recurso | OmniHuman 2.0Até 5 min | OmniHuman 1.5 |
|---|---|---|
| Posicionamento | Avatares falantes longos | Clipes curtos em alta resolução |
| Entrada | Imagem + áudio + prompt opcional | Imagem + áudio + prompt opcional |
| Animação guiada por áudio | Sim | Sim |
| Sincronia labial | Sim | Sim |
| Expressões faciais | Sim | Sim |
| Gestos corporais | Sim | Sim |
| Animação de várias pessoas | Sim | Sim |
| Controle por prompt | Sim | Sim |
| Duração máxima | Até 300 segundos | Menos de 60 segundos |
| Duração | Segue o áudio, 4–300 s | Segue o áudio |
| Resolução de saída | 720p | 720p / 1080p |
| Ideal para | Palestras, cursos, músicas e podcasts | Clipes curtos de avatar em alta resolução |
O OmniHuman 2.0 é o modelo de vídeo com IA da ByteDance guiado por áudio. Ele transforma a imagem de um personagem e um arquivo de áudio em um vídeo de avatar falante com lábios, expressões e gestos sincronizados. O OmniHuman 2.0 funciona com fotos reais, ilustrações e personagens estilizados e cria vídeos de até 5 minutos em 720p.
O OmniHuman 2.0 analisa a fala, o ritmo e a emoção do seu áudio e anima a imagem com lábios, expressões e gestos correspondentes. Um prompt opcional pode guiar ações e câmera. Uma fala clara com pouco ruído de fundo gera a sincronia labial mais precisa.
Envie uma imagem JPG, PNG ou WEBP de até 30 MB, com 300 a 6.000 px por lado e proporção de 0,4 a 2,5. O áudio deve ser MP3 ou WAV, até 15 MB e de 4 a 300 segundos. Se um arquivo não servir, a caixa de envio mostra o motivo exato.
O OmniHuman 2.0 cria vídeos de 4 a 300 segundos (5 minutos). O vídeo sempre tem a duração do áudio e sai em 720p.
O OmniHuman 2.0 usa 28 créditos por segundo de áudio. Um vídeo de 10 segundos custa 280 créditos, um de 1 minuto 1.680 e um de 5 minutos 8.400. O espaço mostra o orçamento exato ao adicionar o áudio. O OmniHuman 2.0 exige VIP.
Sim. O OmniHuman 2.0 pode animar várias pessoas em uma cena, ótimo para entrevistas, podcasts e apresentações em grupo. O resultado depende da imagem, do áudio e da complexidade da cena. Para o resultado mais nítido, use uma imagem em que todos os rostos estejam visíveis e bem iluminados.
O OmniHuman 2.0 cria vídeos mais longos, de até 300 segundos em 720p, ideais para palestras, aulas e músicas. O OmniHuman 1.5 foca em clipes de menos de 60 segundos com até 1080p. Ambos oferecem sincronia labial, expressões e gestos guiados por áudio.
Sim. Adicione um prompt opcional de até 300 caracteres para descrever ações, gestos, cena ou câmera. Funciona em chinês, inglês, japonês, coreano, espanhol e indonésio. O movimento final também segue o áudio.
Sim. Envie uma música em MP3 ou WAV e o OmniHuman 2.0 sincroniza lábios, respiração e ritmo do corpo com a música. Ideal para cantores virtuais, ídolos digitais e videoclipes de até 5 minutos.
Use o OmniHuman 2.0 para apresentadores com IA, anúncios de produto estilo UGC, vídeos de cursos e treinamentos, podcasts em vídeo, cantores virtuais e ilustrações animadas. Qualquer retrato e gravação de voz vira um vídeo falante, sem filmar.
Entre, ative o VIP e abra o espaço do OmniHuman 2.0 a partir desta página. Envie um retrato e seu áudio, adicione um prompt se quiser e gere. Sem código e sem instalar nada. Seu primeiro vídeo falante pode ficar pronto em minutos.