Говорящий аватар OmniHuman 2.0
Загрузите портрет и 4–300 секунд аудио MP3 или WAV. Видео 720p совпадает по длине с аудио. Добавьте промпт до 300 символов, чтобы задать жесты и камеру.
Открыть рабочее пространствоOmniHuman 2.0 — ИИ-модель видео, управляемая звуком: из одного изображения и одного аудио она создаёт реалистичное видео с говорящим аватаром, естественной синхронизацией губ, выразительной мимикой, жестами и длиной до 5 минут.
Изображение + аудио в видео · 720p · 4–300 секунд · промпт по желанию
Один сценарий: загрузите портрет, добавьте речь или пение и при желании опишите игру.
Загрузите портрет и 4–300 секунд аудио MP3 или WAV. Видео 720p совпадает по длине с аудио. Добавьте промпт до 300 символов, чтобы задать жесты и камеру.
Открыть рабочее пространствоOmniHuman 2.0 превращает изображение и ваше аудио в говорящее видео с естественной синхронизацией губ, мимикой и жестами.
Превратите одно изображение и аудиофайл в реалистичное видео с говорящим аватаром в OmniHuman 2.0. Модель оживляет персонажей: речь, мимика и движения тела управляются звуком. Создавайте ИИ-ведущих, виртуальных персонажей и цифровых аватаров без съёмок. Загрузите фото, иллюстрацию или стилизованного персонажа — лицо, одежда и стиль останутся как на исходном изображении.
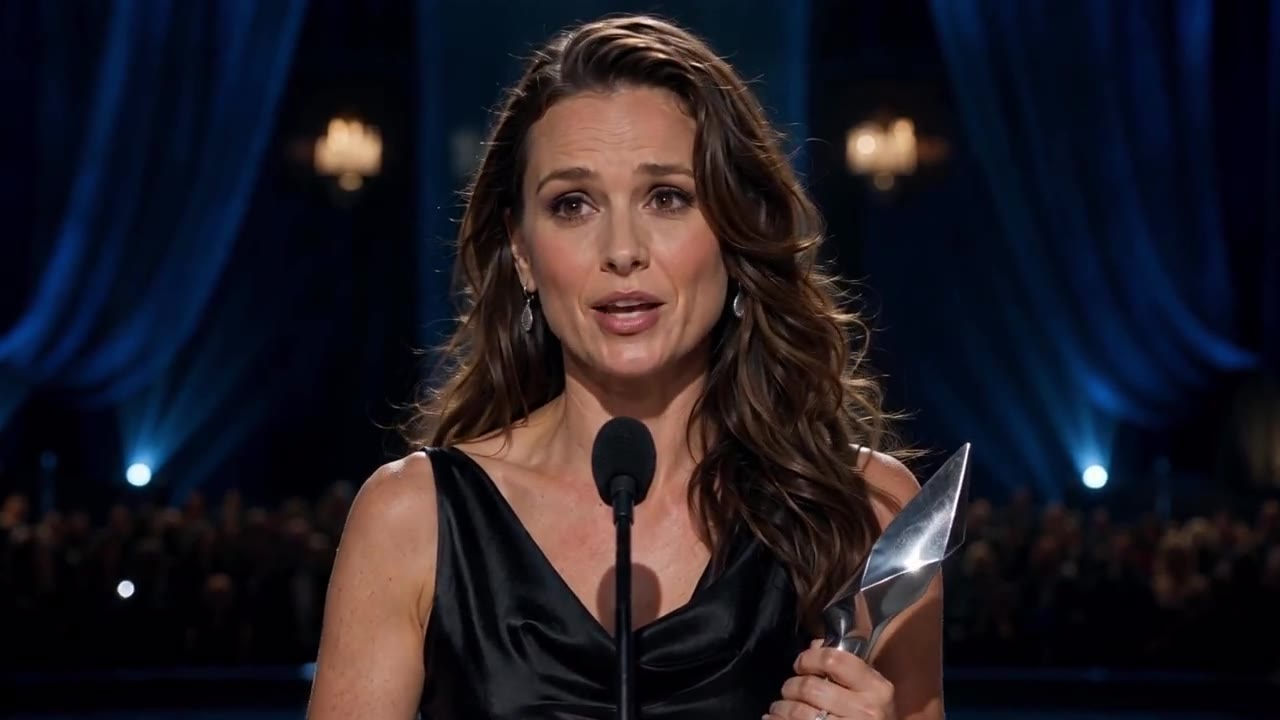
OmniHuman 2.0 создаёт говорящие видео, где движения губ точно следуют словам и пению. Рот синхронизирован со звуком, а остальное лицо двигается естественно. Подходит для виртуальных ведущих, поющих аватаров и анимации персонажей по голосу. Синхронизация держится и на крупных планах, и в быстрых текстах песен, поэтому видео с ведущим и музыкальные номера выглядят убедительно на любом экране.
OmniHuman 2.0 выходит за рамки простой синхронизации губ. Модель создаёт мимику, повороты головы, жесты рук и движения тела в ответ на ритм и эмоции звука. Добавьте ИИ-аватарам характера для историй, развлечений и соцсетей. Спокойный рассказ остаётся мягким, а взволнованный голос даёт более широкие жесты и живую мимику.
OmniHuman 2.0 поддерживает говорящие видео длиной до 300 секунд. Длина ролика следует за аудио — от 4 секунд до 5 минут. Создавайте полные речи, презентации, уроки и песни за один раз, не склеивая короткие фрагменты. Один непрерывный дубль сохраняет лицо, свет и кадр от первого до последнего слова.
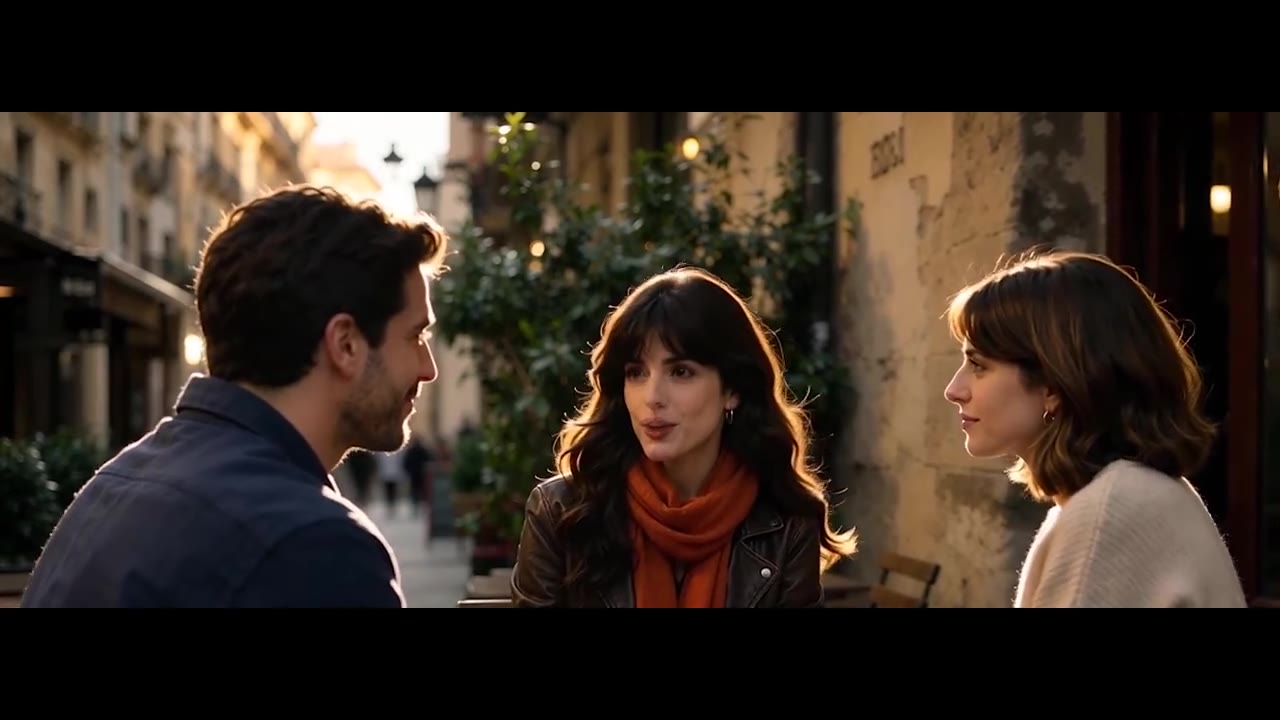
OmniHuman 2.0 может оживить нескольких персонажей в одной сцене. Создавайте беседы, интервью и групповые выступления с мимикой по звуку и естественными движениями. Превращайте подкасты и диалоги в увлекательные видео. Используйте групповое фото или сцену с несколькими людьми и оставьте каждому говорящему место в кадре — так результат будет чётче.
В OmniHuman 2.0 к изображению и аудио можно добавить необязательный текстовый промпт. Опишите действия, жесты, поведение сцены и движение камеры, чтобы задать результат. Сочетайте анимацию по звуку с промптом для более управляемых видео. Например, напишите «улыбается и машет в камеру, медленный наезд», чтобы начать видео о товаре с дружелюбного приветствия.
Создайте реалистичное говорящее видео в OmniHuman 2.0 за три шага:
Войдите и откройте рабочую область OmniHuman 2.0. Загрузите одно чёткое изображение JPG, PNG или WEBP до 30 МБ, 300–6000 px по каждой стороне, с соотношением сторон от 0,4 до 2,5. Подойдут фото, иллюстрации и стилизованные персонажи.
Загрузите речь или пение в MP3 или WAV до 15 МБ и длиной от 4 до 300 секунд. Аудио задаёт длину видео. При желании опишите жесты, сцену или движение камеры — до 300 символов.
Проверьте расчёт кредитов и запустите генерацию. Видео OmniHuman 2.0 появится в диалоге и в разделе «Мои работы», готовое к просмотру и загрузке.
OmniHuman 2.0 расширяет аватары на основе звука до видео длиной 5 минут — для презентаций, пения и цифровых людей. OmniHuman 1.5 делает короткие ролики с выводом до 1080p. Обе модели поддерживают синхронизацию губ, выразительные жесты и анимацию по промпту.
| Возможность | OmniHuman 2.0До 5 мин | OmniHuman 1.5 |
|---|---|---|
| Позиционирование | Длинные видео с аватаром | Короткие ролики высокого разрешения |
| Вход | Изображение + аудио + промпт | Изображение + аудио + промпт |
| Анимация по звуку | Да | Да |
| Синхронизация губ | Да | Да |
| Мимика | Да | Да |
| Жесты тела | Да | Да |
| Анимация нескольких людей | Да | Да |
| Управление промптом | Да | Да |
| Максимальная длина | До 300 секунд | До 60 секунд |
| Длина видео | По длине аудио, 4–300 с | По длине аудио |
| Разрешение | 720p | 720p / 1080p |
| Лучше всего для | Выступления, курсы, песни и подкасты | Короткие ролики с аватаром в высоком разрешении |
OmniHuman 2.0 — ИИ-модель видео от ByteDance, управляемая звуком. Она превращает изображение персонажа и аудиофайл в видео с говорящим аватаром, где губы, мимика и жесты синхронизированы. Модель работает с фото, иллюстрациями и стилизованными персонажами и создаёт видео до 5 минут в 720p.
OmniHuman 2.0 анализирует речь, ритм и эмоции в аудио и оживляет изображение: губы, мимика и жесты совпадают со звуком. Необязательный промпт помогает задать действия и камеру. Чистая речь без фонового шума даёт самую точную синхронизацию губ.
Загрузите одно изображение JPG, PNG или WEBP до 30 МБ, 300–6000 px по стороне, с соотношением от 0,4 до 2,5. Аудио — MP3 или WAV до 15 МБ и длиной 4–300 секунд. Если файл не подходит, окно загрузки укажет точную причину.
OmniHuman 2.0 создаёт видео от 4 до 300 секунд (5 минут). Длина ролика всегда равна длине аудио, разрешение — 720p.
OmniHuman 2.0 тратит 28 кредитов за секунду аудио. Видео на 10 секунд стоит 280 кредитов, на 1 минуту — 1680, на 5 минут — 8400. Точный расчёт появится после добавления аудио. Для OmniHuman 2.0 нужен VIP.
Да. OmniHuman 2.0 может оживить нескольких людей в одной сцене — это удобно для интервью, подкастов и групповых выступлений. Результат зависит от изображения, аудио и сложности сцены. Для лучшего результата используйте изображение, где все лица хорошо видны и освещены.
OmniHuman 2.0 создаёт более длинные видео — до 300 секунд в 720p, для выступлений, уроков и песен. OmniHuman 1.5 рассчитан на ролики до 60 секунд с разрешением до 1080p. Обе модели дают синхронизацию губ, мимику и жесты по звуку.
Да. Добавьте необязательный промпт до 300 символов с описанием действий, жестов, сцены или камеры. Промпты работают на китайском, английском, японском, корейском, испанском и индонезийском. Итоговое движение также следует за звуком.
Да. Загрузите песню в MP3 или WAV, и OmniHuman 2.0 синхронизирует губы, дыхание и ритм тела с музыкой. Подходит для виртуальных певцов, цифровых айдолов и клипов до 5 минут.
OmniHuman 2.0 подходит для ИИ-ведущих, UGC-рекламы товаров, обучающих видео и курсов, видеоподкастов, виртуальных певцов и анимации иллюстраций. Любой портрет и запись голоса станут говорящим видео без съёмок.
Войдите, активируйте VIP и откройте рабочую область OmniHuman 2.0 с этой страницы. Загрузите портрет и аудио, при желании добавьте промпт и запустите. Без кода и установки программ. Первое говорящее видео будет готово за несколько минут.