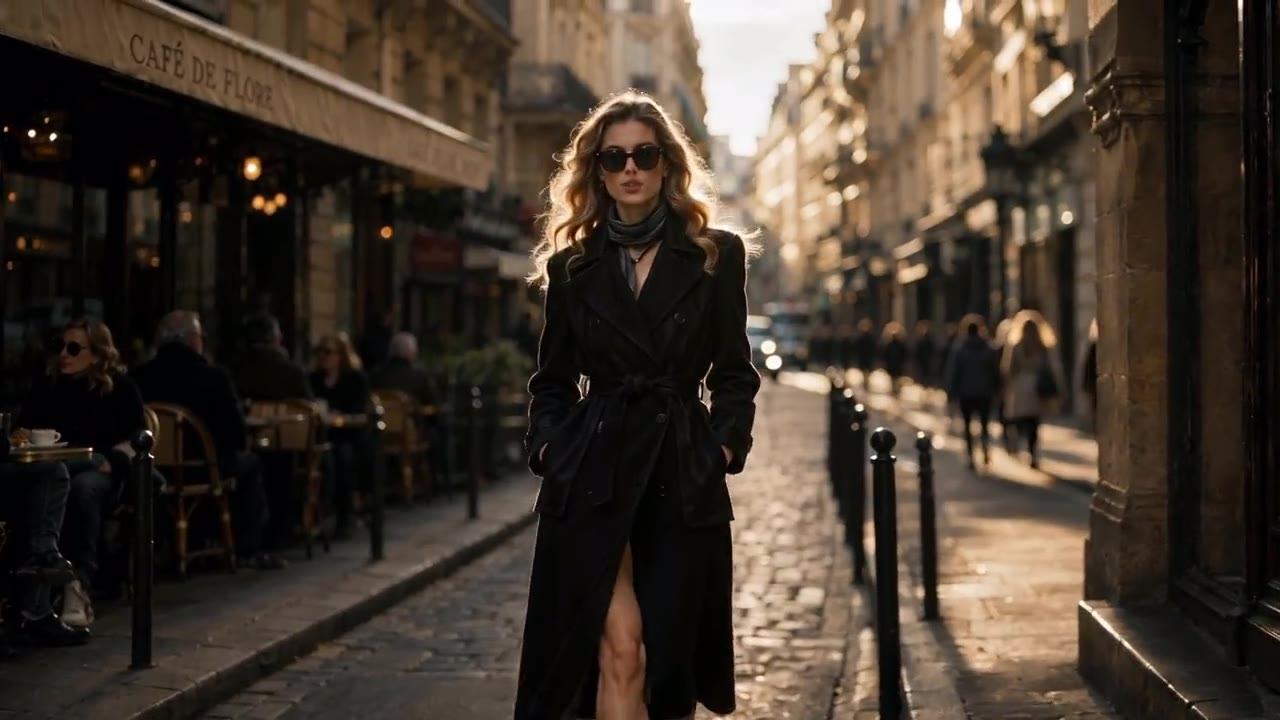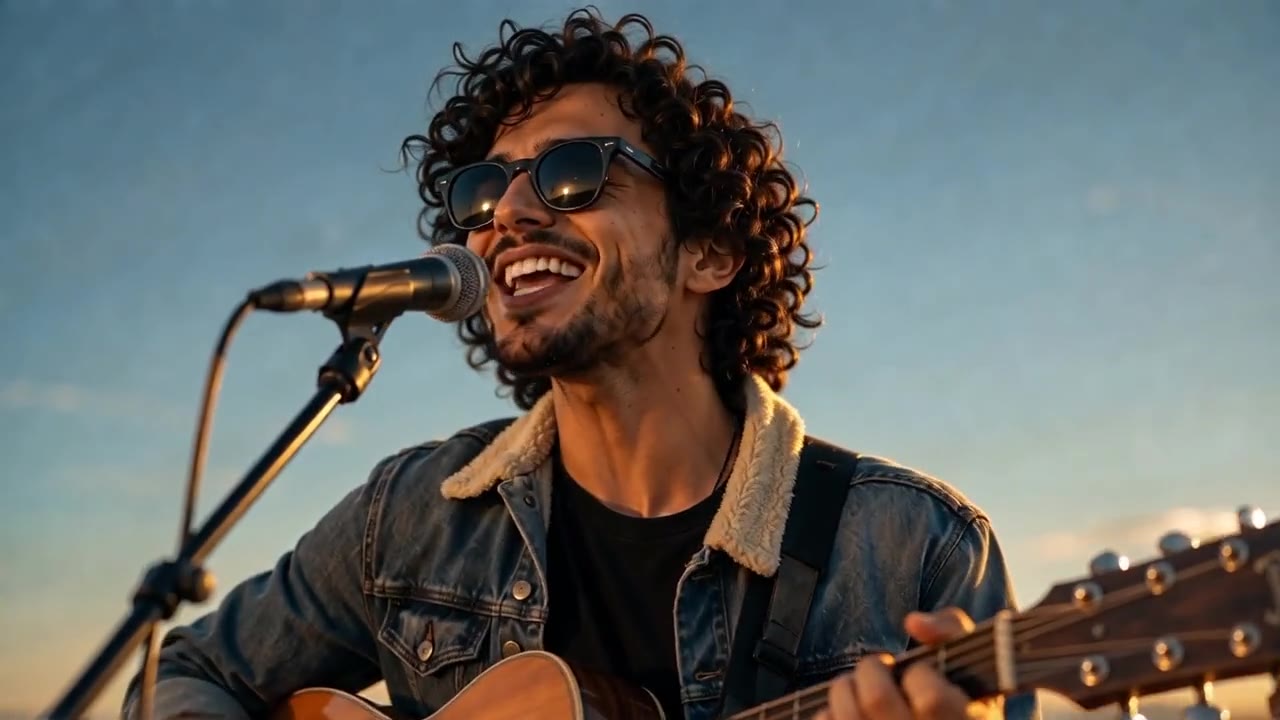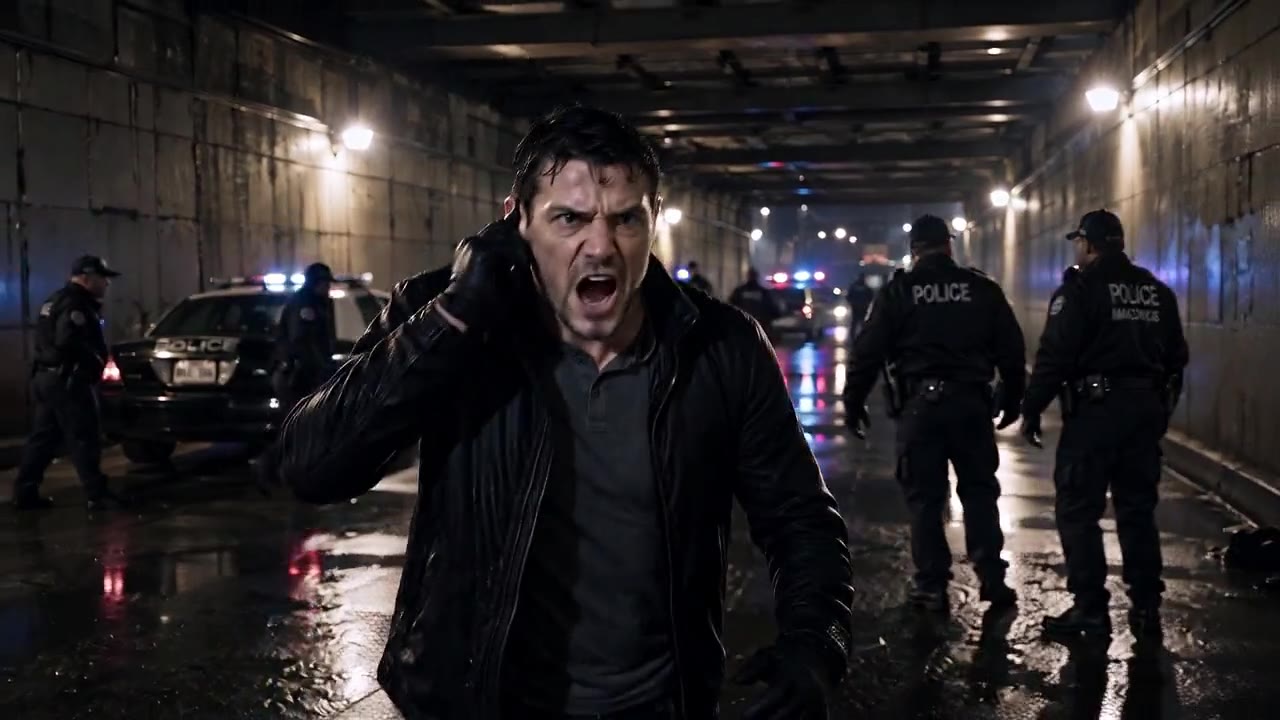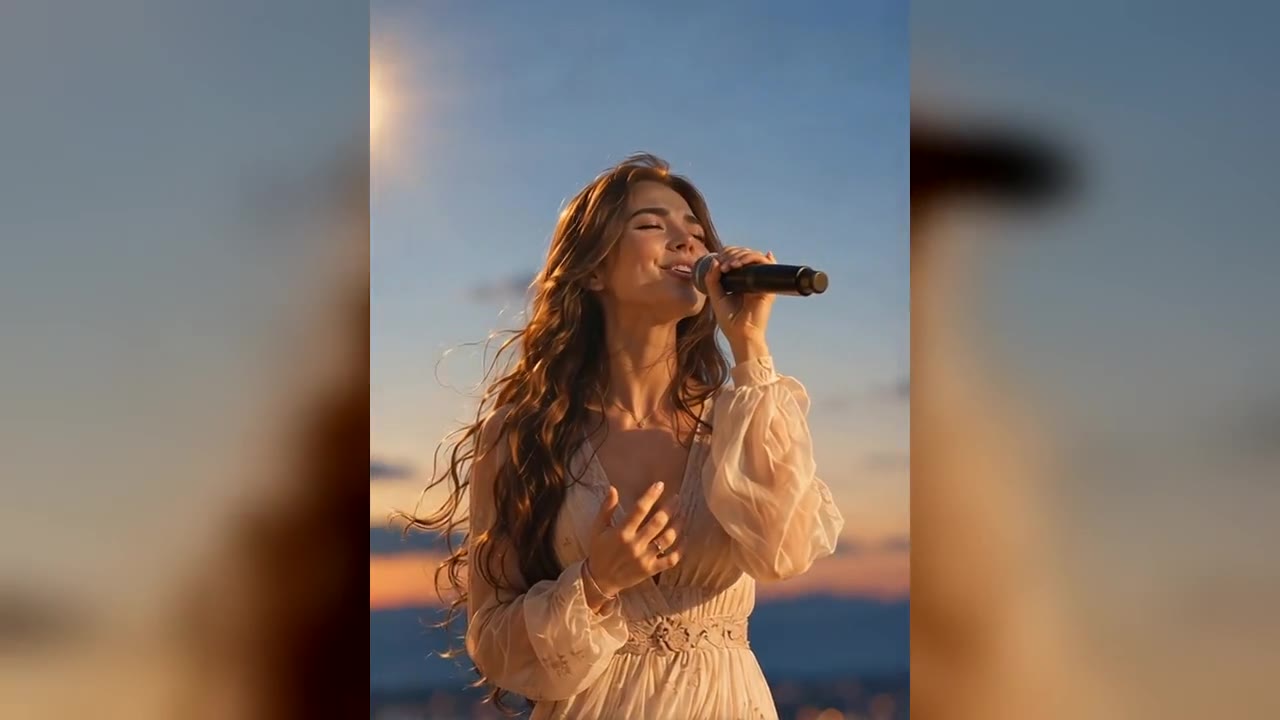
OmniHuman 2.0 토킹 아바타
인물 사진 한 장과 4–300초 MP3 또는 WAV 오디오를 올리면 오디오 길이에 맞춘 720p 영상이 만들어집니다. 최대 300자의 프롬프트로 제스처와 카메라를 지정할 수 있습니다.
작업 공간 열기OmniHuman 2.0은 이미지 한 장과 오디오 하나로 사실적인 토킹 아바타 영상을 만드는 오디오 기반 AI 영상 모델입니다. 자연스러운 립싱크, 풍부한 표정과 몸짓으로 최대 5분 영상을 생성합니다.
이미지 + 오디오 투 비디오 · 720p · 4–300초 · 프롬프트 선택
워크플로 하나: 인물 사진을 올리고 말이나 노래를 넣은 뒤, 원하면 연기를 설명하세요.
인물 사진 한 장과 4–300초 MP3 또는 WAV 오디오를 올리면 오디오 길이에 맞춘 720p 영상이 만들어집니다. 최대 300자의 프롬프트로 제스처와 카메라를 지정할 수 있습니다.
작업 공간 열기OmniHuman 2.0은 이미지 한 장과 오디오로 자연스러운 립싱크, 표정, 몸짓이 살아 있는 토킹 영상을 만듭니다.
OmniHuman 2.0은 이미지 한 장과 오디오 파일 하나로 사실적인 토킹 아바타 영상을 만듭니다. 말투, 표정, 몸동작이 모두 오디오에 맞춰 자연스럽게 움직여 캐릭터에 생명을 불어넣습니다. 촬영 없이 AI 진행자, 가상 캐릭터, 디지털 아바타를 만들어 보세요. 인물 사진, 일러스트, 스타일화 캐릭터 어떤 것이든 원본의 얼굴, 의상, 화풍이 그대로 유지됩니다.
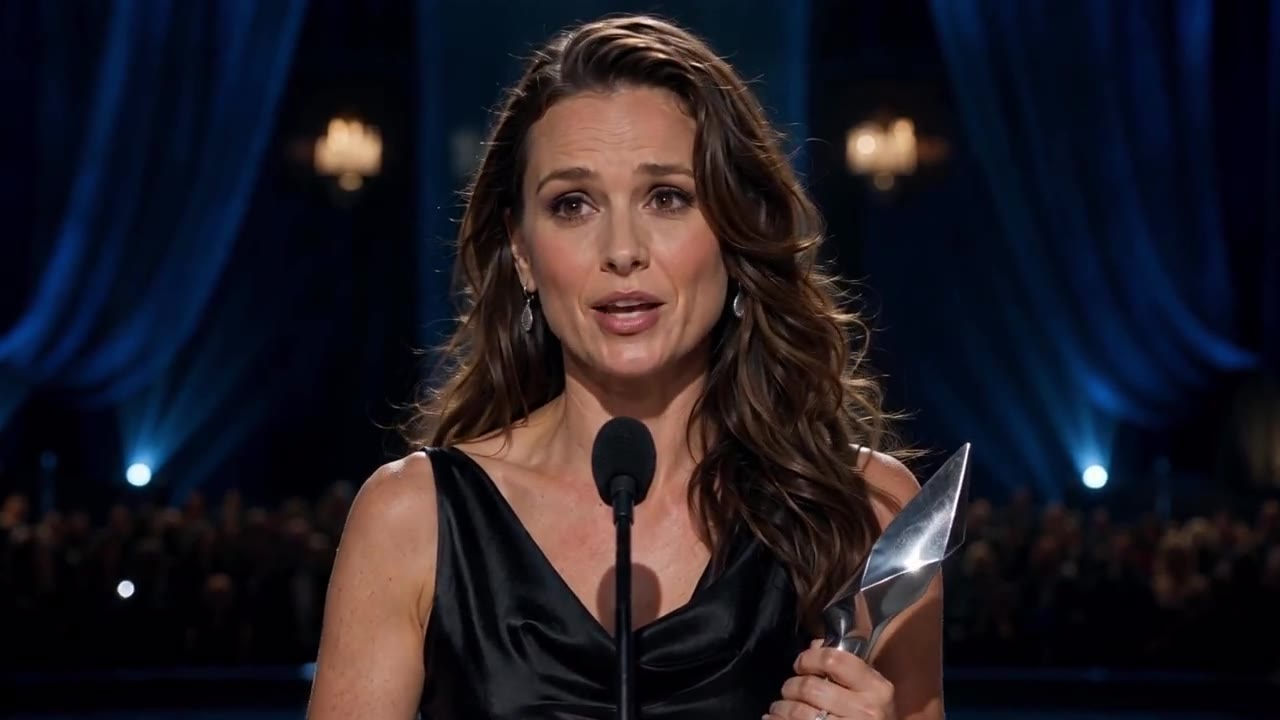
OmniHuman 2.0은 말하는 단어와 노래에 입 모양이 정확히 맞는 영상을 만듭니다. 입은 오디오와 동기화되고 얼굴의 다른 부분도 자연스럽게 움직입니다. 가상 진행자, 노래하는 아바타, 음성 기반 캐릭터 애니메이션에 활용해 보세요. 클로즈업이나 빠른 가사에서도 립싱크가 흔들리지 않아, 토킹 헤드 영상과 음악 공연이 어떤 화면에서도 자연스럽습니다.
OmniHuman 2.0은 기본 립싱크를 넘어섭니다. 오디오의 리듬과 감정에 반응하는 표정, 고개 움직임, 손동작, 몸동작까지 생성합니다. 스토리텔링, 엔터테인먼트, SNS 콘텐츠를 위해 아바타에 개성을 더하세요. 차분한 내레이션은 부드럽게, 흥분된 목소리는 더 큰 제스처와 생생한 표정으로 이어집니다.
OmniHuman 2.0은 최대 300초 길이의 토킹 영상을 지원합니다. 영상 길이는 오디오를 따라 4초부터 5분까지 정해집니다. 짧은 클립을 이어 붙일 필요 없이 연설, 발표, 튜토리얼, 노래를 한 번에 완성하세요. 한 번에 이어지는 테이크로 첫 마디부터 마지막까지 얼굴, 조명, 구도가 그대로 유지됩니다.
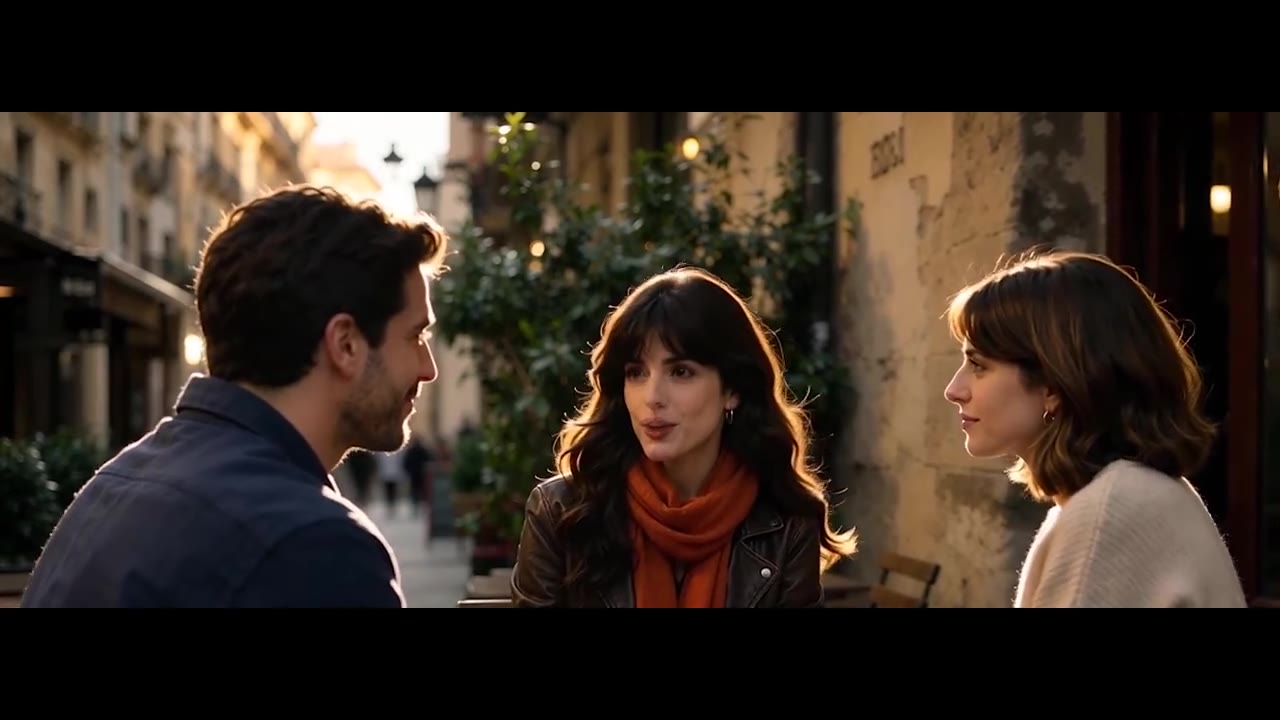
OmniHuman 2.0은 한 장면에서 여러 캐릭터를 움직일 수 있습니다. 오디오 기반 표정과 자연스러운 몸동작으로 대화, 인터뷰, 그룹 퍼포먼스를 만드세요. 팟캐스트 음성과 대화를 몰입감 있는 영상으로 바꿔 줍니다. 단체 사진이나 여러 사람이 있는 장면을 쓰고, 말하는 사람마다 화면에 충분한 공간을 주면 결과가 가장 선명합니다.
OmniHuman 2.0에서는 이미지와 오디오에 선택형 텍스트 프롬프트를 더할 수 있습니다. 동작, 제스처, 장면 연출, 카메라 움직임을 적어 결과를 다듬으세요. 오디오 기반 애니메이션과 프롬프트를 함께 쓰면 더 정교하게 연출됩니다. 예를 들어 “카메라를 보며 웃고 손을 흔든다, 천천히 줌인”이라고 쓰면 제품 영상을 친근한 인사로 시작할 수 있습니다.
OmniHuman 2.0에서 세 단계로 사실적인 토킹 영상을 만드세요:
로그인 후 OmniHuman 2.0 작업 공간을 여세요. 30MB 이하, 각 변 300–6,000px, 화면 비율 0.4–2.5의 선명한 JPG, PNG, WEBP 이미지 한 장을 올리면 됩니다. 사진, 일러스트, 스타일화 캐릭터 모두 가능합니다.
MP3 또는 WAV 형식의 말이나 노래를 올리세요(15MB 이하, 4–300초). 영상 길이는 오디오가 정합니다. 원하면 300자 이내로 제스처, 장면, 카메라 움직임을 적어 주세요.
크레딧 견적을 확인하고 생성하세요. OmniHuman 2.0 영상은 대화와 ‘내 작품’에 표시되어 바로 미리 보고 다운로드할 수 있습니다.
OmniHuman 2.0은 오디오 기반 아바타를 최대 5분 영상까지 확장해 발표, 노래, 디지털 휴먼에 적합합니다. OmniHuman 1.5는 최대 1080p의 짧은 클립용입니다. 둘 다 립싱크, 풍부한 제스처, 프롬프트 기반 애니메이션을 지원합니다.
| 기능 | OmniHuman 2.0최대 5분 | OmniHuman 1.5 |
|---|---|---|
| 포지셔닝 | 장편 토킹 아바타 | 짧은 고해상도 클립 |
| 입력 | 이미지 + 오디오 + 선택 프롬프트 | 이미지 + 오디오 + 선택 프롬프트 |
| 오디오 기반 애니메이션 | 지원 | 지원 |
| 립싱크 | 지원 | 지원 |
| 얼굴 표정 | 지원 | 지원 |
| 몸동작 | 지원 | 지원 |
| 다인원 애니메이션 | 지원 | 지원 |
| 텍스트 프롬프트 제어 | 지원 | 지원 |
| 최대 영상 길이 | 최대 300초 | 60초 미만 |
| 영상 길이 | 오디오에 맞춤, 4–300초 | 오디오에 맞춤 |
| 출력 해상도 | 720p | 720p / 1080p |
| 추천 용도 | 강연, 강의, 노래, 팟캐스트 | 짧은 고해상도 아바타 클립 |
OmniHuman 2.0은 ByteDance의 오디오 기반 AI 영상 모델입니다. 캐릭터 이미지와 오디오 파일로 입 모양, 표정, 몸짓이 동기화된 토킹 아바타 영상을 만듭니다. 실사 사진, 일러스트, 스타일화 캐릭터 모두 가능하며 최대 5분의 720p 영상을 만듭니다.
OmniHuman 2.0은 오디오의 말, 리듬, 감정을 분석해 이미지 속 인물이 그에 맞는 입 모양, 표정, 몸짓을 하도록 움직입니다. 선택형 프롬프트로 동작과 카메라도 지정할 수 있습니다. 배경 소음이 적고 또렷한 음성일수록 립싱크가 가장 정확합니다.
JPG, PNG, WEBP 이미지 한 장(30MB 이하, 각 변 300–6,000px, 비율 0.4–2.5)을 올리세요. 오디오는 MP3 또는 WAV, 15MB 이하, 4–300초여야 합니다. 파일이 맞지 않으면 업로드 상자가 정확한 이유를 알려 줍니다.
OmniHuman 2.0은 4초부터 300초(5분)까지 영상을 만듭니다. 영상 길이는 항상 오디오와 같고 720p로 제공됩니다.
OmniHuman 2.0은 오디오 1초당 28크레딧을 씁니다. 10초 영상은 280, 1분은 1,680, 5분은 8,400크레딧입니다. 오디오를 추가하면 작업 공간에 정확한 견적이 표시됩니다. OmniHuman 2.0은 VIP 전용입니다.
네. OmniHuman 2.0은 한 장면에서 여러 인물을 움직일 수 있어 인터뷰, 팟캐스트, 그룹 퍼포먼스에 잘 맞습니다. 결과는 이미지, 오디오, 장면의 복잡도에 따라 달라집니다. 가장 선명한 결과를 원하면 모든 얼굴이 잘 보이고 조명이 밝은 이미지를 사용하세요.
OmniHuman 2.0은 최대 300초의 720p 영상을 만들어 강연, 강의, 노래에 적합합니다. OmniHuman 1.5는 최대 1080p의 60초 미만 클립에 집중합니다. 둘 다 오디오 기반 립싱크, 표정, 제스처를 제공합니다.
네. 최대 300자의 선택형 프롬프트로 동작, 제스처, 장면, 카메라를 설명하세요. 중국어, 영어, 일본어, 한국어, 스페인어, 인도네시아어를 지원합니다. 최종 동작은 오디오도 함께 따릅니다.
네. MP3 또는 WAV 노래를 올리면 OmniHuman 2.0이 입, 호흡, 몸의 리듬을 음악에 맞춥니다. 가상 가수, 디지털 아이돌, 최대 5분 뮤직비디오에 적합합니다.
OmniHuman 2.0은 AI 진행자, UGC 스타일 제품 광고, 강의·교육 영상, 비주얼 팟캐스트, 가상 가수, 일러스트 애니메이션에 활용됩니다. 인물 사진과 음성 녹음만 있으면 촬영 없이 토킹 영상이 됩니다.
로그인하고 VIP를 활성화한 뒤 이 페이지에서 OmniHuman 2.0 작업 공간을 여세요. 인물 사진과 오디오를 올리고 원하면 프롬프트를 더해 생성하면 됩니다. 코드도 설치도 필요 없습니다. 첫 토킹 영상이 몇 분 만에 완성됩니다.